任务状态同步系统生产设计:全链路、状态机、实时通知与高可用

真正可靠的任务看板,不是“WebSocket 一直在线”,而是:状态先成为可恢复的事实,通知只负责让事实更快到达,任何一层短暂故障后都能重新收敛到正确状态。
文件解析、AI 生成、视频转码、报表导出这类异步任务,通常会经过多个服务和步骤。用户真正关心的往往不是复杂的工作流编排,而是几个朴素问题:
- 我的新任务是否已经创建?
- 当前是等待、运行、成功,还是失败?
- 当前由哪个服务执行什么功能,不同功能的数据该如何展示?
- 哪个步骤正在执行,已经用了多久?
- 步骤失败、自动重试或执行器失联时,用户如何收到明确告知?
- 页面断线、刷新或切到后台后,会不会永远停在旧状态?
- 服务多副本、节点重启、网络闪断时,状态通知是否仍能恢复?
本文设计一套专注于任务状态、步骤状态和耗时展示的生产链路。它不负责启动下一步、不替代工作流引擎,也不把实时消息系统当数据库。
最终方案可以概括为:
Business API 创建 workflowId 与独立 taskId
  → Worker 按 taskId 上报状态
  → Task Status Service 事务校验与落库
  → 同事务写 MySQL Outbox
  → Outbox Relay 领取并调用 Centrifugo 发布
  → 用户摘要频道 + 任务详情频道
  → 前端按 version 合并
  → 恢复失败时重新读取数据库快照
一、先划清系统边界
1.1 这套系统负责什么
| 能力 | 具体职责 |
|---|---|
| 当前状态 | 保存任务与步骤当前处于哪个状态 |
| 耗时 | 保存起止时间和最终耗时,支持运行中本地计时 |
| 上报校验 | 校验任务归属、执行轮次、事件幂等和状态转换 |
| 实时展示 | 将已经提交的状态近实时通知给授权用户 |
| 断线恢复 | 短断线尝试消息恢复,恢复失败读取业务快照 |
| 多租户权限 | 只让用户订阅自己有权查看的任务 |
| 可观测性 | 监控状态写入、Outbox 积压、发布延迟、连接与恢复结果 |
1.2 它明确不负责什么
- 不决定下一步执行哪个服务;
- 不创建和调度 Worker;
- 不因为“目前已知步骤都成功”就猜测总任务成功;
- 不把频道历史当永久事件审计库;
- 不保证 Worker 已完成业务但尚未上报的状态自动出现;
- 不为页面上每秒变化的耗时发送一次消息。
如果系统需要 DAG 编排、补偿、人工审批、长周期定时器和跨服务重试,应交给 Temporal、Camunda、Argo Workflows 等编排能力。状态系统只观察和展示,不悄悄演化成第二套工作流引擎。
二、总体架构:事实层、通知层、展示层
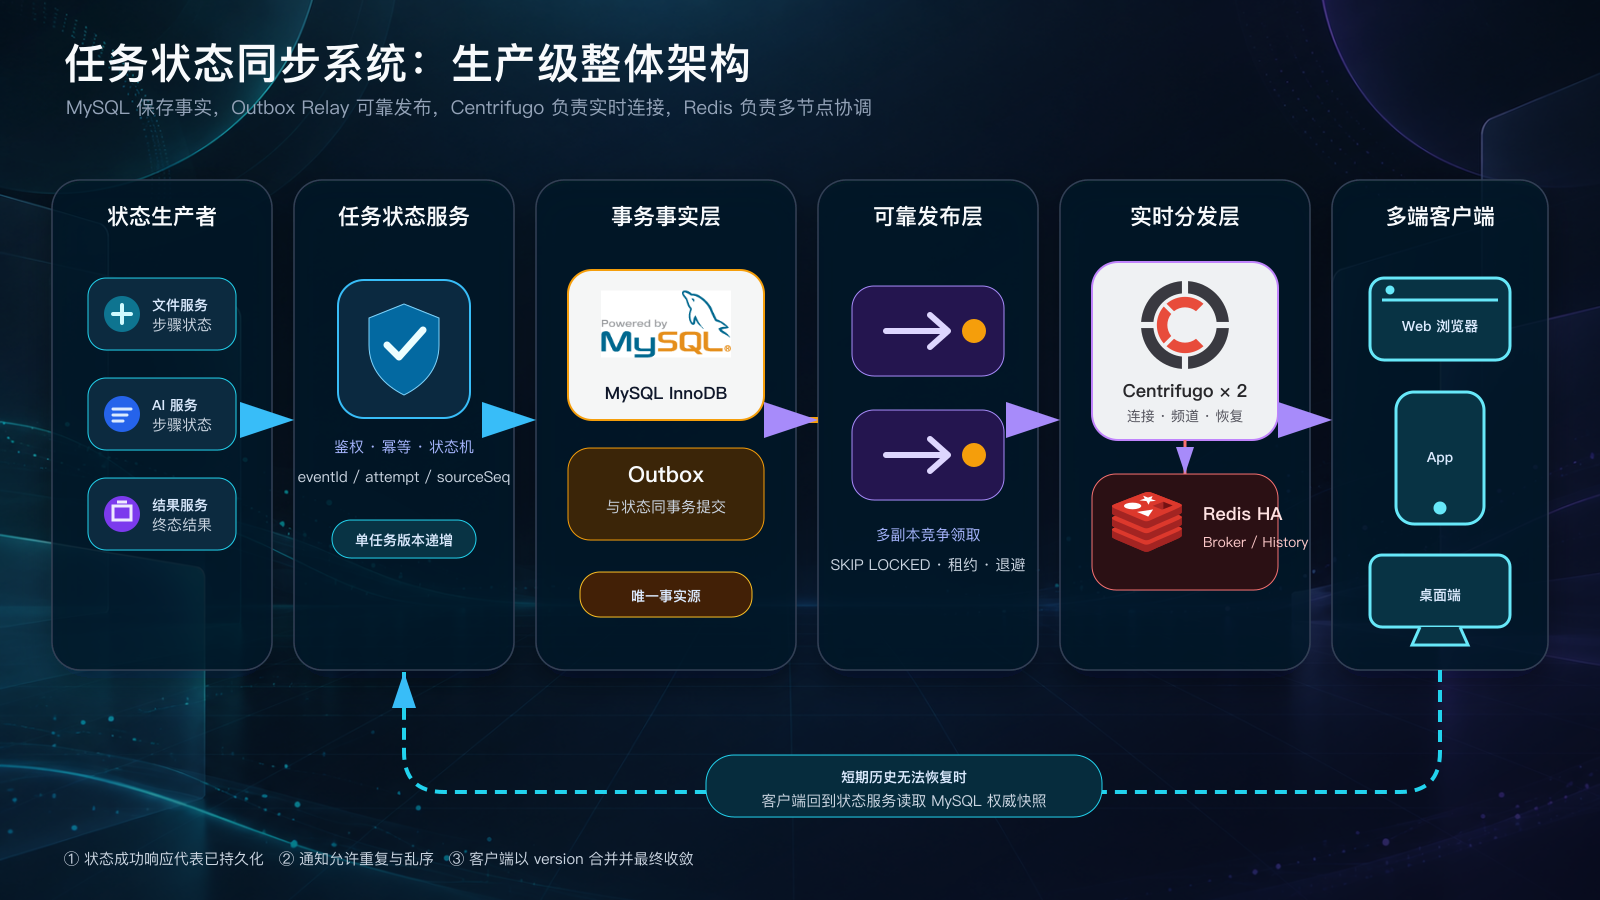
整体架构图:MySQL 保存权威事实,Centrifugo 与 Redis 负责实时分发和短期恢复;虚线表示实时链路无法证明连续时的快照兜底。
品牌标识来源:MySQL 官方 Logo 页面、Centrifugo 官方项目、Redis 官方项目。
三层的职责不能互相替代:
- MySQL 是事实源:回答“任务现在到底是什么状态”。
- Centrifugo 是通知与短期恢复层:回答“如何让在线客户端尽快知道变化”。
- 前端状态仓库是视图:按版本合并快照与推送,不能反向成为权威状态。
Centrifugo 官方也把频道历史定义为有界缓存,而不是永久消息队列;历史不足时,应用应回到自己的数据库恢复状态。参见 Stream history and recovery。
三、完整链路:从创建任务到页面显示完成
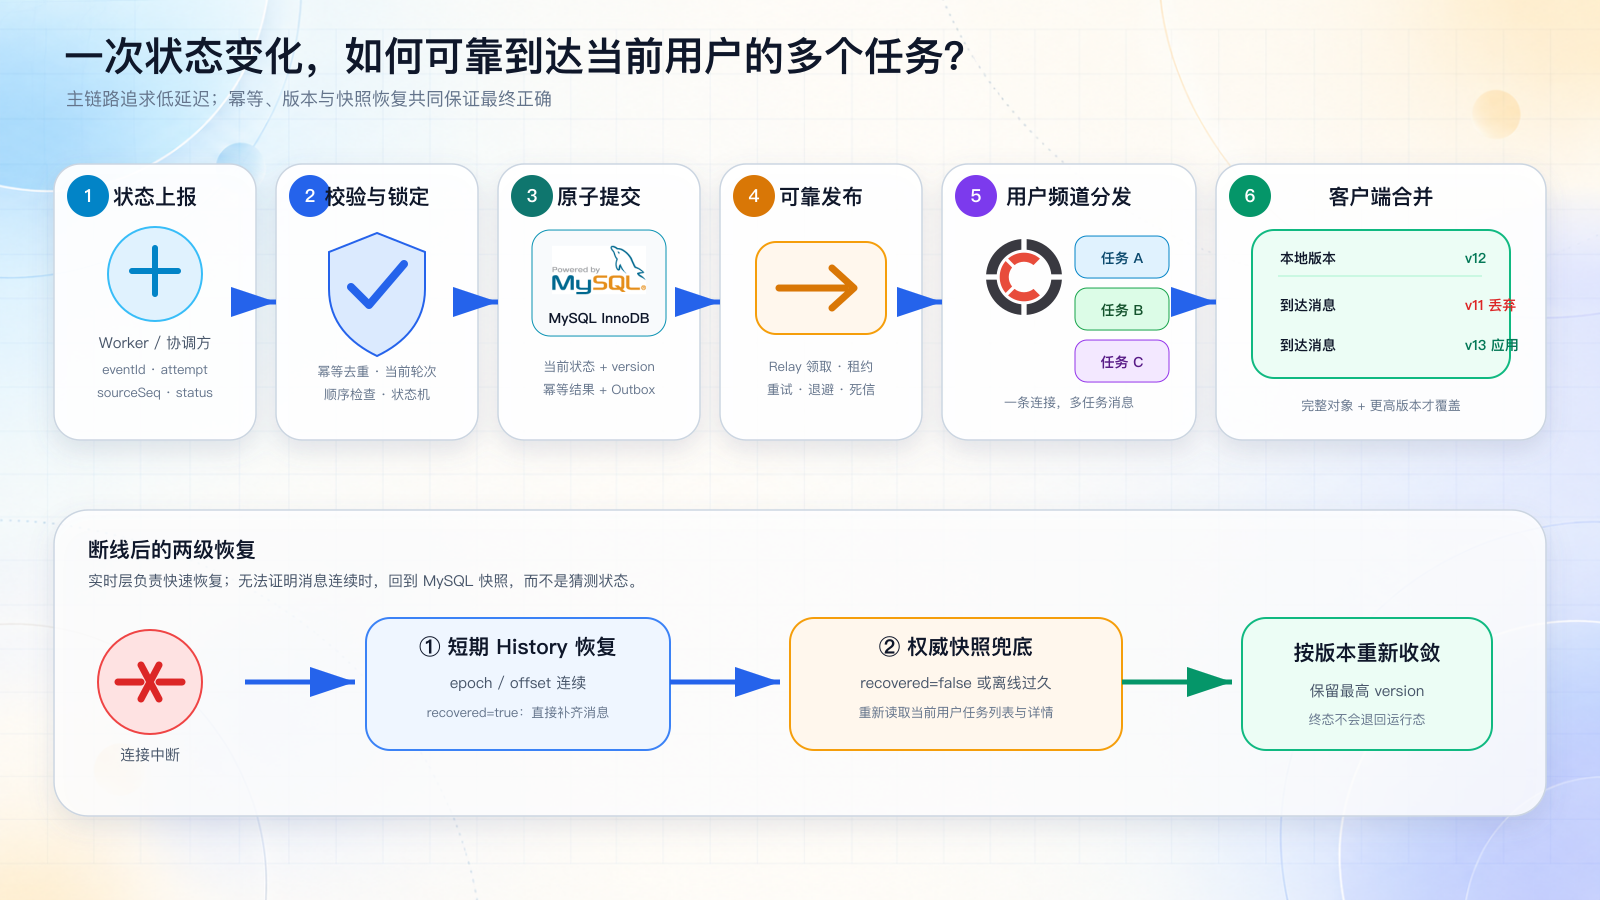
核心流程图:写入成功只代表事实已经持久化;通知可重复、可乱序,客户端以版本合并,断线后采用 History 与 MySQL 快照两级恢复。
3.1 先创建 workflow,再创建独立任务
最顶层不再叫 taskId,而叫 workflowId。它表示一次用户请求、业务流程或编排实例;它下面可以只有一个任务,也可以随着执行动态增加多个任务。每个真正能够独立运行、重试、取消或结束的工作单元才分配 taskId。
workflowId = wf-20260922-001        一次“处理整批材料”的业务流程
  ├─ taskId = task-upload          独立上传任务
  ├─ taskId = task-parse           独立解析任务
  ├─ taskId = task-ai              独立 AI 分析任务
  └─ taskId = task-report          独立报告生成任务
       └─ stepId / executionId     任务内部步骤及某次实际执行
workflowId 解决顶层归组、列表导航和整体进度问题;taskId 才是状态写入、幂等、版本、分片与详情订阅的权威聚合根。不要把 workflow 本身再称为“顶层 task”,也不要让多个独立任务共享一个 taskVersion。
任务创建时不一定已经知道完整 taskType、productId 和所有步骤。例如 AI Agent 可能运行中才决定调用检索、OCR、代码执行或人工审批。状态服务应支持三种模式:
| 模式 | 创建时提供什么 | 适用场景 |
|---|---|---|
| 固定 Manifest | taskType、定义版本、全部步骤 | 固定 ETL、转码、审批流 |
| 最小任务 | 只创建任务信封,步骤运行中注册 | Agent、动态工具调用、未知中间步骤 |
| 混合模式 | 固定主干步骤,允许在授权节点下动态增加子步骤 | 大多数生产系统,推荐默认值 |
最小创建请求只需要当前确实明确的 workflow 信息;首批任务可以为空,也可以随请求一起创建:
{
  "clientWorkflowKey": "order-20260921-0088",
  "ownerId": "user-42",
  "title": "处理用户上传的一批材料",
  "workflowType": null,
  "initialTasks": [
    {
      "clientTaskKey": "upload-contract",
      "title": "上传合同",
      "taskType": null,
      "productId": null,
      "knownSteps": []
    }
  ]
}
tenantId、authorityScope、coordinatorId 不由请求自由填写,而是从登录身份、mTLS 或服务凭证得到。状态服务先幂等创建稳定 workflowId,再为首批独立任务分配各自的 taskId 和通用生命周期 PENDING。后续新增任务使用 workflowId + clientTaskKey 幂等注册;任务内部未知步骤仍通过 execution 注册接口加入。
两个版本域必须分开:
workflowVersion:只排序 workflow 元数据、任务成员变化和整体聚合状态;taskVersion:只排序一个taskId内的步骤、状态、健康与结果变化。
即使 task-a.taskVersion=18、task-b.taskVersion=3,也不能认为 task-a 比 task-b “更新”;它们是两条完全独立的版本轴。workflow 聚合器观察到子任务变化后,可以把整体进度更新为新的 workflowVersion,但不能覆盖任何子任务的 taskVersion。
这里的“不固化”不是允许 Worker 在普通事件里随便写一个新 stepId。注册执行实例和上报执行事件必须是两个动作:前者创建受控上下文,后者只能引用已经注册并签发 Token 的上下文。这样既支持动态流程,又不会因为字段拼错、重试或恶意请求制造大量影子步骤。
单库首版中,workflow、首批任务、已知步骤和通知命令应在同一个事务里提交。后续按 task 分库时,workflow 注册和 task 创建通过幂等命令与读模型收敛,不能使用跨库事务。无论哪种部署,都不能出现下面的缺口:
task 已经提交
  → 进程崩溃
  → 还没有调用实时发布 API
  → 页面长期不知道任务存在
创建接口响应和实时消息可能乱序:推送可能先到,也可能 HTTP 响应先到。前端不能用“收到一条就追加一行”,而应以 workflowId 定位顶层流程、以 taskId 定位子任务,并分别使用 workflowVersion 与 taskVersion 判断新旧。
3.1.1 动态步骤必须先注册,再上报状态
当中间服务运行到一个创建时未知的功能时,由 Coordinator 或持有 REGISTER_CHILD_EXECUTION 权限的父 execution 调用:
POST /internal/v1/tasks/task-8a4d/executions:register
Authorization: Bearer <coordinator-or-parent-execution-token>
Idempotency-Key: register:task-8a4d:tool-call-17:attempt-1
{
  "clientStepKey": "tool-call-17",
  "parentExecutionId": "exec-agent-01",
  "operationCode": "SEARCH.WEB",
  "producerId": "search-service",
  "attempt": 1,
  "displayName": "检索公开资料",
  "failurePolicy": "CONTINUE_WITH_WARNING"
}
状态服务根据调用方身份、父 execution 权限和通用功能策略创建 stepId + executionId,再返回短期 executionHandle。相同 clientStepKey + attempt 重试返回同一个执行实例,不能重复创建:
{
  "stepId": "dyn_tool-call-17",
  "executionId": "exec-01JQ...",
  "executionHandle": "exh_7PKf3uB6S9Qn",
  "taskVersion": 4,
  "created": true
}
动态注册必须限制:
- 哪些服务身份可以注册子步骤,普通 Worker 默认只能给自己的 execution 上报;
- 允许的
operationCode或命名空间,例如父 Agent 只能创建SEARCH.*、TOOL.*; - 每个任务的最大动态步骤数、最大嵌套深度、每分钟注册数和并行 execution 数;
producerId必须与实际服务身份匹配,不能由调用方伪装;- 只有 Coordinator 能提交
TASK_COMPLETED/TASK_FAILED,动态子步骤不能结束总任务。
3.1.2 中间状态很多时,不要全部固化成状态机节点
一个服务内部可能出现几十甚至几百个中间阶段。它们要分成三类:
| 类型 | 示例 | 是否不可变落事件 | 是否通知客户端 |
|---|---|---|---|
| 生命周期事实 | STARTED、COMPLETED、FAILED、CANCELLED | 必须 | 必须,不能合并终态 |
| 用户可见阶段/进度 | OCR_PAGE、MODEL_INFERENCE、UPLOADING | 节流后保存最新快照 | 按时间或进度阈值合并 |
| 调试遥测 | 单个模型 token、每页日志、内部重试堆栈 | 不进入任务状态事件库 | 进入日志、指标或 Trace |
未预注册的细粒度阶段可以放在 phaseCode,但它不能改变生命周期、终态、严重级别或重试策略:
{
  "eventType": "STEP_PROGRESS",
  "lifecycleStatus": "RUNNING",
  "phaseCode": "OCR_PAGE",
  "phaseLabel": "正在识别第 37 页",
  "progress": {"current": 37, "total": 200, "unit": "page"},
  "progressSeq": 81
}
Reporter SDK 可以每秒接收数百次本地变化,但只在满足“经过 1~5 秒、进度跨过阈值、阶段改变或出现异常”时上报。状态服务再次按 executionId 合并可覆盖进度,只为实际持久化和发布的快照增加版本。最终 COMPLETED/FAILED 到达时必须先冲刷或覆盖最后进度,不能被节流队列丢弃。
3.1.3 productId 可以不要求创建时明确,但不要拿它承担安全职责
productId 可以设计成可空、无需预注册的业务标签。创建任务时传 null,运行过程中识别出业务归属后再补充;即使永远为空,通用任务状态链路也应正常工作。
“不约束”建议指不要求提前进入产品注册表,也不阻塞任务创建,而不是完全不做输入治理:
- 仍限制长度、字符集和 payload 大小,避免索引膨胀与日志注入;
- 变更必须经过 Coordinator 权限、乐观版本和审计事件;
- 不用于计算虚拟桶,不用于判断谁能订阅或上报;
- 不用于决定终态、保留期、计费账户或数据隔离边界;
- 客户端不认识该值时使用通用任务卡,而不是拒绝消息。
如果系统确实需要稳定的计费、保留或合规策略,应分别保存不可随意变化的 billingAccountId、retentionPolicyId、dataClassification,不要复用一个可变 productId。最终形成以下边界:
tenantId + authorityScope  = 安全与归属,创建时必须明确且不可变
ownerId                    = 用户可见范围,创建时明确
workflowId                 = 顶层业务流程身份,用于关联多个独立任务
taskId                     = 独立任务身份,每个任务创建一次后全链路透传
productId                  = 可选业务标签,可以稍后补充
taskType                   = 可选业务分类,绑定状态定义后冻结
operationCode              = 每个 execution 注册时明确
phaseCode                  = 可动态变化的细粒度中间阶段
3.2 步骤开始与完成
Worker 不直接写任务表,也不直接向浏览器发布。它向状态服务上报业务事实:
POST /internal/tasks/8a4d/events
Content-Type: application/json
Idempotency-Key: 019a-event-001
{
  "eventId": "019a-event-001",
  "workflowId": "wf-20260922-001",
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "producerId": "document-parser",
  "sourceSeq": 2,
  "eventType": "STEP_COMPLETED",
  "businessStatus": "PARSE_COMPLETED",
  "occurredAt": "2026-09-21T07:10:18Z",
  "durationMs": 18000,
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {"pageCount": 36, "language": "zh-CN"}
  }
}
服务端处理顺序如下:
这些防线分别解决不同问题:
| 字段或机制 | 解决的问题 | 规则 |
|---|---|---|
executionToken | 服务越权替其他任务或功能上报 | 绑定任务、步骤、功能、轮次、生产者和允许事件类型 |
operationCode | 无法判断上报的具体功能 | 必须匹配创建时预登记或运行时显式注册的 execution |
data.schema | 不同功能数据结构混用 | 必须属于该功能定义或受限通用 Profile 允许的 Schema |
eventId | 请求超时后的重复提交 | 同一次重试必须使用相同 ID 和相同内容 |
attempt | 上一次执行晚到并覆盖新一轮 | 旧轮次只能被忽略,不能改变当前轮次 |
sourceSeq | 同一轮次内部乱序 | 只接受比当前序号更大的状态变化 |
version | HTTP、推送和多端接收乱序 | 服务端每次有效变更递增,客户端只接收新版本 |
3.3 先统一十一类标识:流程、任务、功能和事件各自独立
同一个任务可以由文档服务、AI 服务和结果服务依次或并行处理。它们不能只传一个模糊的 status,而要携带足够上下文,让状态服务知道“这是哪类任务、哪个业务功能、哪个逻辑步骤、哪一次执行、由谁产生、在该来源中的第几个事件”。
| 标识 | 生成方 | 生命周期 | 作用 |
|---|---|---|---|
authorityScope | 状态服务根据认证身份确定 | 整个任务不变 | 定义谁能注册步骤、上报事件和读取任务,是不可缺失的安全命名空间 |
productId | 业务 API / Coordinator | 可为空,可审计更新 | 用于产品归类、搜索和展示,不参与鉴权、分片和幂等 |
workflowId | Workflow / Business API | 整个顶层流程不变 | 把同一次业务流程产生的多个独立任务关联起来 |
taskId | Coordinator / Task Status Service | 单个任务不变 | 聚合一个独立任务中不同服务产生的步骤与事件 |
taskType | 业务 API / Coordinator | 可先为空;绑定定义后固定 | 区分 DOCUMENT_PROCESS、VIDEO_EXPORT 等整类业务任务 |
stepId | 任务模板或注册接口 | 同一逻辑步骤不变 | 标识预定义或动态注册的步骤,如 02_parse、dyn_tool-call-17 |
operationCode | 功能注册表 / 注册接口 | execution 创建后不变 | 标识步骤实际执行的功能,如 DOCUMENT.PARSE、SEARCH.WEB |
attempt | Coordinator | 每次重试递增 | 隔离旧执行实例的晚到事件 |
producerId | 服务身份系统 | 服务实例或逻辑生产者 | 说明谁在上报,但不等同于业务功能 |
eventId | 事件生产服务 | 每次业务事件唯一 | HTTP 超时重试时保持相同,用于幂等 |
sourceSeq | 事件生产服务 | 在 taskId + stepId + attempt + producerId 内递增 | 判断同一生产者事件的先后顺序 |
serviceName/producerId 和 operationCode 必须分开:一个 AI 服务可能同时实现摘要、翻译和分类三个功能;同一个 DOCUMENT.PARSE 功能以后也可能从旧解析服务迁移到新解析服务。用服务名判断功能,会让扩容、重构和灰度发布直接改变业务语义。
authorityScope 和 productId 也必须分开。前者类似可信的应用/业务域命名空间,由凭证确定并参与权限判断;后者只是业务分类,可以创建时未知、稍后补充甚至按审计规则修改。不能因为 productId=null 就让任务失去安全边界,也不能让调用方通过修改 productId 获得另一个产品的订阅或上报权限。
协调方启动步骤时,应把不可缺失的执行上下文传给服务,而不是让服务自己猜:
{
  "workflowId": "wf-20260922-001",
  "taskId": "task-8a4d",
  "authorityScope": "content-platform",
  "productId": null,
  "taskType": null,
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "executionId": "exec-01JQ...",
  "producerId": "document-parser",
  "statusDefinitionVersion": null,
  "operationDefinitionVersion": 2,
  "heartbeatIntervalSeconds": 15,
  "heartbeatTimeoutSeconds": 60,
  "executionToken": "short-lived-signed-token"
}
executionToken 由状态服务或协调方签发并绑定以上已知字段以及允许的 eventType。服务 A 不能拿服务 B 的 Token 给另一个步骤上报,也不能把 DOCUMENT.PARSE 改成 VIDEO.TRANSCODE,更不能把 attempt=1 改成 attempt=2。taskType/productId 尚未分类时可以为空,但 Worker 无权借普通事件自行补写;应由 Coordinator 使用带版本条件的元数据命令更新。executionId 唯一标识这一次实际执行实例,重启后如果不能安全恢复原执行,应创建新 attempt 和新 execution。状态服务以数据库中的注册结果和 Token 为准;请求体中的功能字段只是显式自描述,必须完全匹配,不能由 Worker 自由声明。
sourceSeq 也不能只放在进程内存中:来源服务应把“业务结果、本地待上报事件、下一序号”放在自己的持久化事务或可靠 Outbox 中。服务重启后继续同一 attempt 时恢复序号;如果是一次真正的重新执行,则由 Coordinator 创建新的 stepAttempt。
3.3.1 不同功能下发不同数据:稳定信封 + 带版本的数据体
所有功能共享同一层稳定信封,客户端先依据 kind + taskId + version 完成路由与去重;taskType/operationCode 已知时选择专用渲染器,为空或未知时使用通用任务卡。只有 data 是功能特有内容:
{
  "kind": "task.detail",
  "schemaVersion": 1,
  "workflowId": "wf-20260922-001",
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "eventType": "STEP_COMPLETED",
  "taskVersion": "12",
  "stepVersion": "4",
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {
      "pageCount": 36,
      "language": "zh-CN",
      "resultRef": "result://document/task-8a4d/parse-v2"
    }
  }
}
视频转码功能可以使用完全不同的数据体,但不能改变公共信封:
{
  "taskType": "VIDEO_EXPORT",
  "operationCode": "VIDEO.TRANSCODE",
  "eventType": "STEP_PROGRESS",
  "data": {
    "schema": "video.transcode.progress.v1",
    "value": {
      "frame": 18420,
      "totalFrames": 30000,
      "fps": 48.2,
      "preset": "1080p-h264"
    }
  }
}
下发数据还要按受众做投影,而不是把同一份大 JSON 广播给所有频道:
| 投影视图 | 面向对象 | 数据范围 |
|---|---|---|
USER_SUMMARY | 当前用户任务列表 | 标题、功能摘要、总状态、进度、用户可读异常,不含步骤原始结果 |
TASK_DETAIL | 已授权且正在查看详情的客户端 | 步骤、operationCode、功能特有 data、脱敏错误与操作建议 |
PROJECT_BROADCAST | 项目成员 | 聚合进度和非敏感告警,不含个人输入、结果地址和诊断信息 |
SYSTEM_BROADCAST | 所有在线用户 | 维护与服务状态,不携带任何业务任务数据 |
data.schema 必须登记在该 operationCode 允许的 Schema 列表中。兼容字段可以在同一版本追加;删除、改名或改变含义必须发布新版本。状态服务负责 JSON Schema 校验、字段白名单、大小限制和敏感字段裁剪,大结果只下发短期授权的 resultRef,不能直接塞进实时消息。
前端按功能注册渲染器,未知功能或未知 Schema 使用通用状态卡降级,不能因此丢弃任务的生命周期状态:
const renderer = operationRenderers[message.operationCode]?.[message.data?.schema];

return renderer
  ? renderer(message.data.value)
  : renderGenericTaskState(message.lifecycleStatus, message.businessStatus);
3.3.2 不同服务与同一个任务,靠什么真正绑定在一起
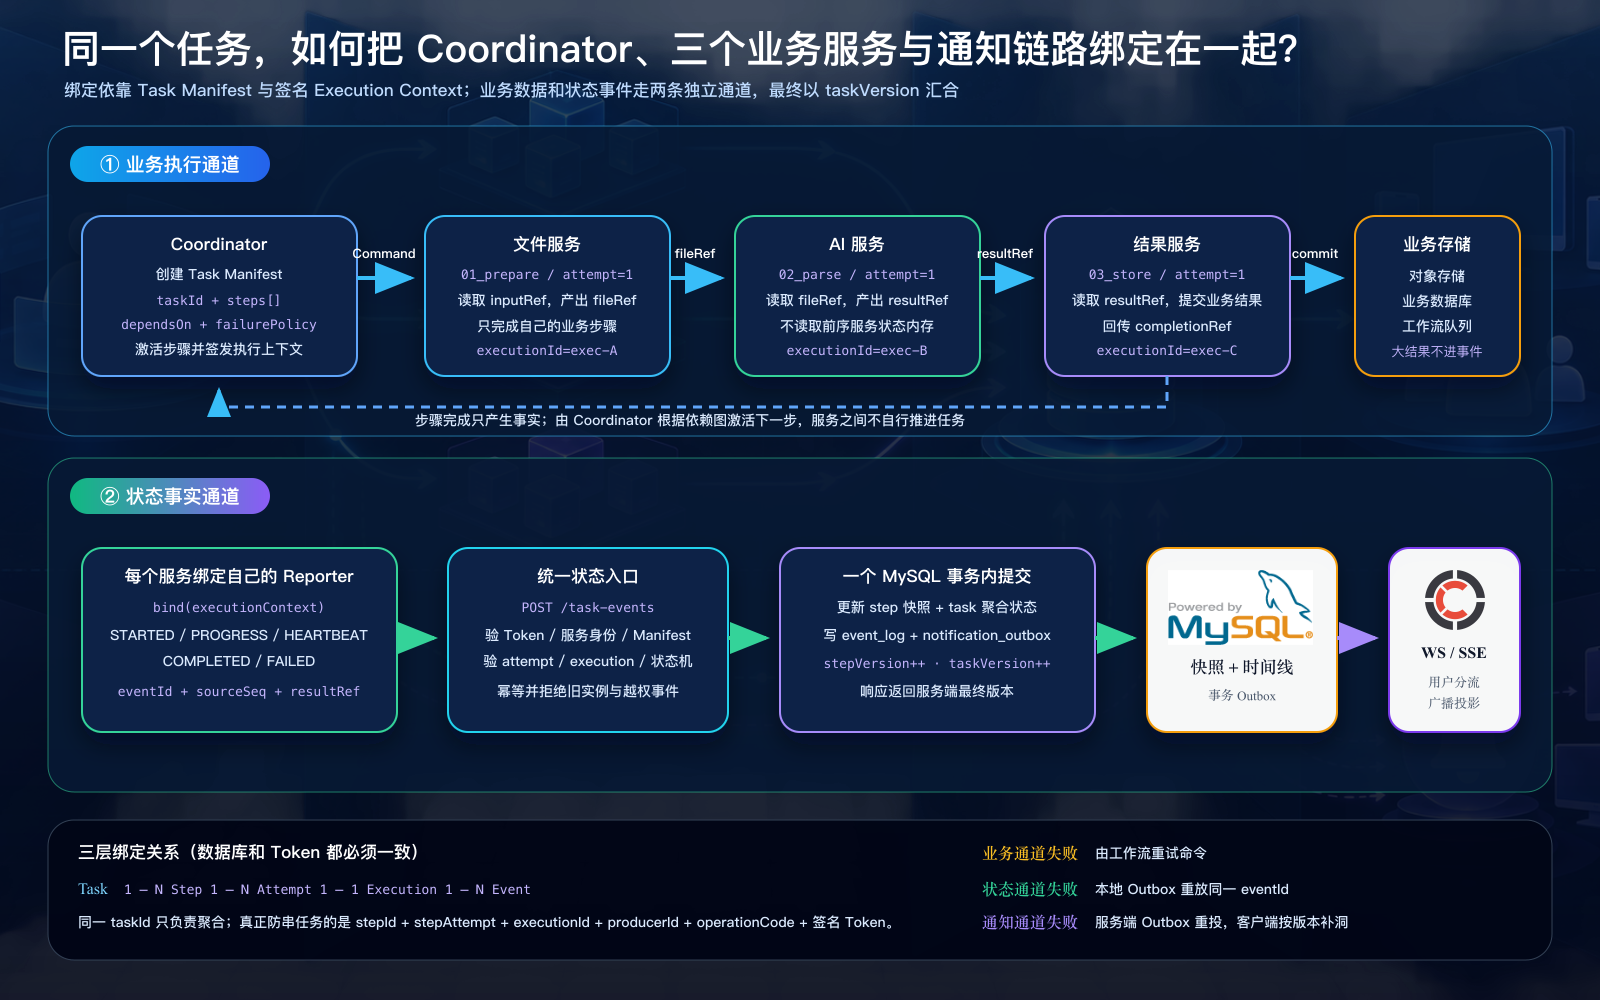
上半部分传业务指令和结果引用,下半部分传状态事实。服务之间不接力转发状态;每个服务都使用自己的执行凭证直连 Task Status Service。
这里不能只靠“大家都记得带同一个 taskId”。一个可校验的绑定至少分为三层:
Workflow Envelope(顶层业务流程与任务成员关系)
  └─ Task Envelope(一个独立任务的稳定信封)
       └─ Step Registry(预定义或动态注册的步骤)
            └─ Attempt / Execution Context(本次执行凭证)
                 └─ Event(本次执行产生的不可变事实)
第一层是 Business API 创建的 Workflow Envelope,它保存顶层归属、展示信息和任务成员关系。第二层才是 Coordinator 注册的 Task Envelope;每个 task 只固定自己的稳定归属、安全边界和状态机,步骤注册表可以随运行过程通过受控命令扩展。下面是其中一个 task 的混合模式:已知主干步骤预登记,同时允许 Agent 在自己的父 execution 下创建有限的动态子步骤。
{
  "workflowId": "wf-20260922-001",
  "taskId": "task-8a4d",
  "authorityScope": "content-platform",
  "productId": null,
  "taskType": null,
  "taskAttempt": 1,
  "knownSteps": [
    {
      "stepId": "01_prepare",
      "operationCode": "FILE.PREPARE",
      "expectedProducer": "file-service",
      "dependsOn": [],
      "failurePolicy": "FAIL_TASK"
    }
  ],
  "dynamicRegistrationPolicy": {
    "allowedParentOperations": ["AGENT.RUN"],
    "allowedChildOperations": ["SEARCH.*", "TOOL.*"],
    "maxDynamicSteps": 100,
    "maxDepth": 4,
    "maxParallelExecutions": 10
  }
}
因此权威定义不是“一创建就永远不变的一张完整 DAG”,而是“稳定任务信封 + 事务化步骤注册日志 + 当前 execution”。每次动态注册同样增加 taskVersion、写不可变事件和 Outbox,客户端才能看到新步骤是何时、由谁、基于哪个父 execution 创建的。
第三层是预定义步骤被激活或动态步骤注册成功时签发的 Execution Context。它把“任务、步骤、功能、执行轮次、执行实例和生产者”冻结在一个短期签名 Token 中。业务命令必须连同输入引用一起携带它:
{
  "commandId": "cmd-01JS...",
  "commandType": "PARSE_DOCUMENT",
  "inputRef": "object://private-bucket/task-8a4d/source.pdf",
  "taskContext": {
    "workflowId": "wf-20260922-001",
    "taskId": "task-8a4d",
    "taskType": "DOCUMENT_PROCESS",
    "stepId": "02_parse",
    "operationCode": "DOCUMENT.PARSE",
    "stepAttempt": 1,
    "executionId": "exec-01JQ...",
    "producerId": "document-parser",
    "sourceSeqStart": 1,
    "executionToken": "signed-step-token"
  }
}
完整时序:先申请 workflowId,再为每个独立任务申请 taskId
先看任务申请与三个服务正常完成时的主链路:
失败重试是另一条明确的时序:新的重试必须创建新 attempt 和新 execution,旧实例不能复活。
这张图里最顶层只申请一次 workflowId;每出现一个需要独立重试、取消、权限或终态的工作单元,再在该 workflow 下幂等申请独立 taskId。一个 taskId 后续全链路保持不变;每到一个新的可观察步骤,Coordinator 再向状态服务激活步骤并取得新的 Execution Context。图中采用“强可见顺序”:业务服务先确保自己的状态事实已被接受,再把 resultRef + statusVersion 返回给 Coordinator,Coordinator 才激活下一步,因此业务返回和状态提交不会留下无法判断的竞态窗口。
如果运行中又产生 task-b,它只复用 workflowId,不能复用 task-a 的 taskVersion、stepId、executionId、sourceSeq 或 Token。状态服务分别锁定两条 task 行、分配两条版本序列,并为各自写事件与 Outbox;task-a 失败不会自动把 task-b 改成失败,workflow 的最终状态由明确的聚合策略或 Coordinator 命令决定。
如果业务更重视状态服务故障期间仍能继续推进,Worker 不能无限等待,可以先把完成事件写入本地 Outbox,再向 Coordinator 返回 resultRef + statusPending=true + eventId。Coordinator 在激活下一步前等待该 eventId 被状态服务接受,或执行幂等对账补交。两种模式都不能在完全不知道完成事件是否可恢复的情况下静默推进下一步。
这里有两条容易被忽略的边界:
inputRef/resultRef走工作流队列、RPC、对象存储或业务数据库,是业务数据通道;事件里只放可展示摘要与授权引用,不能把大结果当状态消息传递。STEP_STARTED/PROGRESS/COMPLETED/FAILED从当前服务直接发往 Task Status Service,是状态事实通道;文件服务不能替 AI 服务转发或改写状态,浏览器也不能作为可信中转站。
第四层是事件。状态服务收到事件时,不相信请求体自己声称的含义,而是逐项做等值校验:
| 请求字段 | 必须匹配的权威来源 | 不匹配时的处理 |
|---|---|---|
taskId + stepId | 创建时预登记或运行时显式注册的 Step Registry | 404/409,普通事件不能创建影子步骤 |
operationCode + producerId | 步骤定义与服务身份 | 403,记录越权审计 |
stepAttempt + executionId | 当前激活的执行实例 | 旧实例返回 STALE_EXECUTION |
eventType | Token 中允许的事件集合 | 403,防止普通 Worker 结束总任务 |
data.schema | 功能注册表固定版本 | 422,拒绝错误功能数据 |
eventId + payloadHash | 幂等记录 | 同 ID 同内容返回原结果;不同内容冲突 |
sourceSeq | 当前 execution 的最后序号 | 重复返回原结果,倒退或跳变按策略拒绝 |
因此数据库中的绑定关系应明确到执行实例,而不是把所有事件扔进只有 task_id 的一张表:
task 1 ── N task_step
task_step 1 ── N step_attempt
step_attempt 1 ── 1 current_execution
current_execution 1 ── N task_event

唯一事件流 = taskId + stepId + stepAttempt + executionId + producerId
对应第五节的物理表,task_step 的每一行就是一个步骤 attempt,主键包含 task_id + step_id + attempt,execution_id 固定该轮实际执行实例;task_event_log 再使用相同的步骤轮次、执行实例和来源序号保存事件。上面的 current_execution 是逻辑角色,不要求额外再建一张表。
当文件服务完成 01_prepare 后,它只提交“步骤已完成”和 fileRef。是否激活 02_parse 由 Coordinator 读取依赖图后决定,并为 AI 服务签发新的 Context。这样前一个服务崩溃、重复回调或被替换,都不能偷偷推进后一个步骤。
重试也有清晰边界:网络超时重发同一命令时,保持相同 commandId、executionId 和 eventId;只有业务确认需要重新执行时,Coordinator 才增加 stepAttempt 并创建新的 executionId。旧执行晚到的完成事件会被识别为 STALE_EXECUTION,不能覆盖新一轮结果。
3.3.3 同一个服务并发执行多个任务,如何保证上报不串线
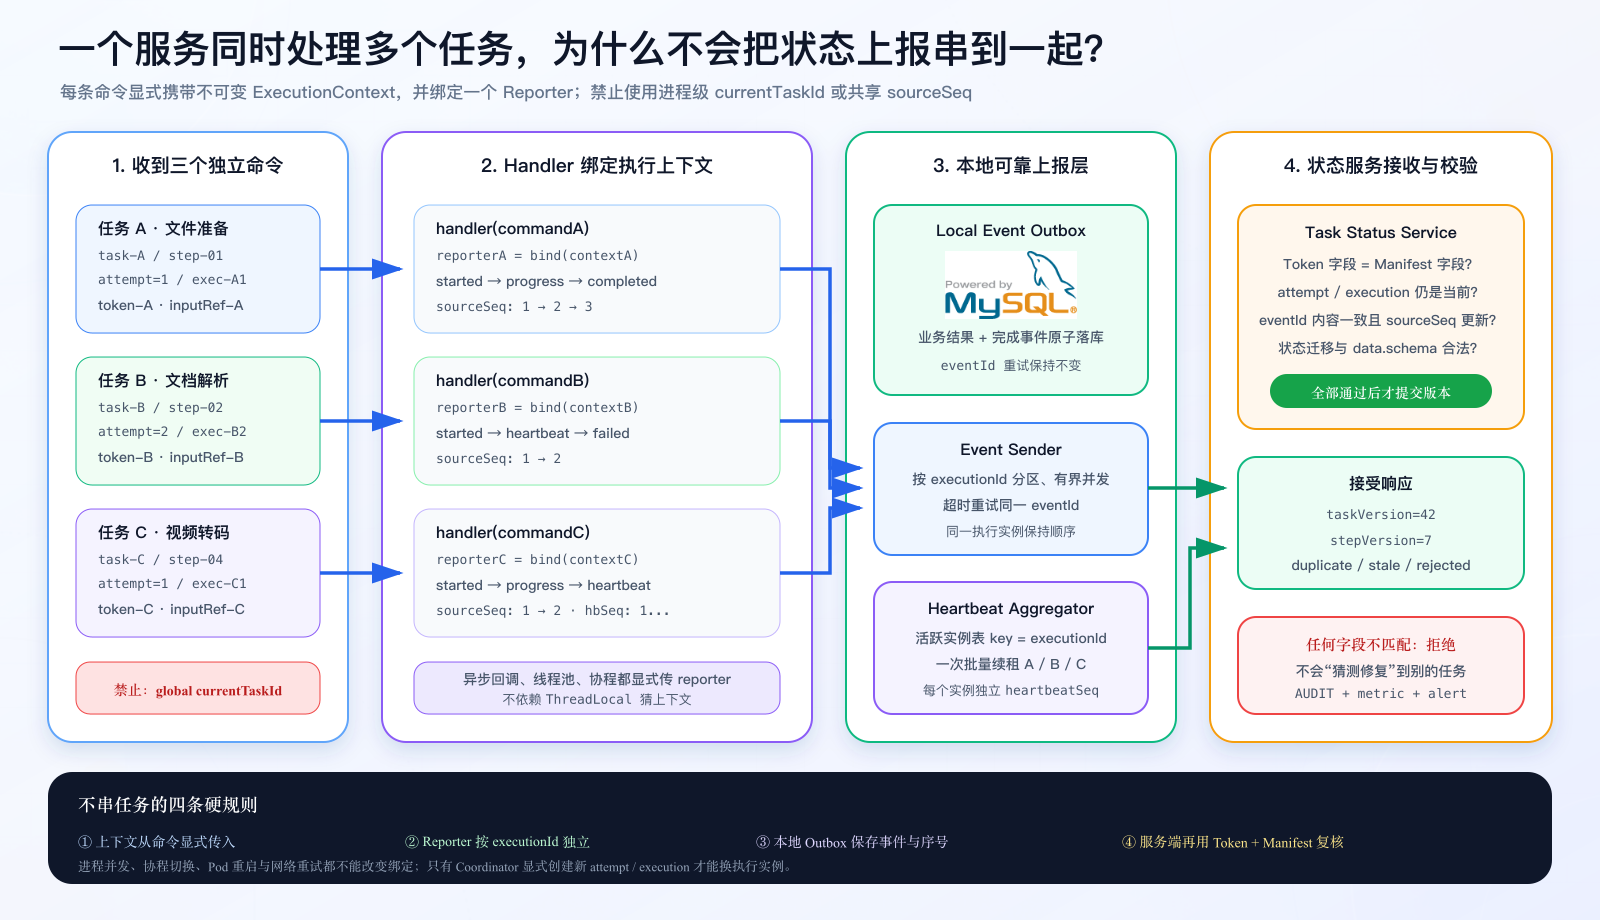
Reporter 不是全局单例状态,而是“共享发送能力 + 每个 execution 独立上下文”。即使异步回调乱序或 Pod 重启,事件仍能回到正确的任务与步骤。
服务收到命令后,应立即用 taskContext 创建一个只属于该执行实例的 Reporter,并把 Reporter 显式传给业务处理函数:
async function handle(command: ParseDocumentCommand) {
  const reporter = reporterFactory.bind(command.taskContext);

  await reporter.started({ eventId: command.startedEventId });

  try {
    const result = await parseDocument(command.inputRef, {
      onProgress: progress => reporter.progress(progress),
      heartbeat: () => reporter.heartbeat()
    });

    // 业务结果与“待发送完成事件”写入同一个本地事务。
    await localTransaction(async tx => {
      await tx.parseResult.save(result);
      await tx.taskEventOutbox.enqueue(
        reporter.completedEvent({
          eventId: command.completedEventId,
          data: { resultRef: result.ref }
        })
      );
    });
  } catch (error) {
    await reporter.failed(classifyAndRedact(error));
    throw error;
  } finally {
    reporter.close();
  }
}
reporterFactory 可以是共享单例,但 reporter 必须持有不可变的执行上下文,并且所有可变计数都限定在 executionId 内:
type BoundReporter = {
  readonly taskId: string;
  readonly stepId: string;
  readonly stepAttempt: number;
  readonly executionId: string;
  nextSourceSeq(): Promise<number>;
  started(...args: unknown[]): Promise<void>;
  progress(...args: unknown[]): Promise<void>;
  heartbeat(): Promise<void>;
  completedEvent(...args: unknown[]): LocalOutboxEvent;
  failed(error: SafeError): Promise<void>;
  close(): void;
};
不要使用下面这些“看似省事”的实现:
- 进程全局的
currentTaskId/currentStepId:并发任务一定会互相覆盖; - 服务级共享
sourceSeq:不同任务会产生无意义的大量序号空洞; - 只依赖
ThreadLocal:异步回调、协程切换和线程池复用后容易丢失或继承错误上下文; - 业务提交成功后再临时发完成事件:进程恰好在两步之间崩溃时,任务将永远显示执行中;
- 上报失败时创建新
eventId:会把一次业务事实写成多次状态变化。
服务内部建议按下面的责任拆开:
| 组件 | 以什么键隔离 | 责任 |
|---|---|---|
CommandDeduplicator | commandId | 防止队列重复投递导致重复执行 |
BoundReporter | executionId | 固定上下文,生成该执行流的 sourceSeq |
LocalEventOutbox | eventId | 在本地持久化待上报事件,重启后继续发送 |
EventSender | executionId 分区 | 同一执行内保序,不同执行间可并发 |
HeartbeatAggregator | executionId | 批量续租多个活跃任务,各自维护 heartbeatSeq |
| Task Status Service | Token + Manifest | 第二次校验,拒绝串线、旧轮次和越权事件 |
状态接口暂时不可用时,业务线程不应无限阻塞。STEP_PROGRESS 可以合并为最新值;STARTED/COMPLETED/FAILED 等状态事实进入本地 Outbox,后台发送器使用原 eventId 指数退避重试。业务结果和完成事件应尽可能在服务自己的本地事务中同时落库,从而避免“结果已经成功,但状态永远停在运行中”。
如果业务结果存储与本地 Outbox 无法共用数据库事务,就要使用可恢复的业务幂等键和对账任务:对账器发现结果已存在但完成事件缺失时,重建同一个确定性 eventId,而不是制造新的成功事件。
状态服务最终接受一次事件后,会在一个 MySQL 事务中完成下面的闭环:
校验 Token / Manifest / 当前 execution
  → 锁定 task 与 task_step
  → 校验 eventId、sourceSeq、状态机和 data.schema
  → 更新步骤快照与任务聚合状态
  → stepVersion++ / taskVersion++
  → 写不可变事件日志与通知 Outbox
  → COMMIT
  → 返回最终 taskVersion / stepVersion
  → Centrifugo 按用户摘要、任务详情或广播投影下发
客户端永远以状态服务返回和推送的版本为准。某条 WS/SSE 消息丢失时,客户端用 afterTaskVersion 补事件或重新拉取快照;它不需要知道事件来自哪个 Pod,也不需要依赖三个业务服务的到达顺序。
3.3.4 上下文很长会不会拖慢:全量只传一次,高频事件使用紧凑引用
不需要在每次心跳、进度或完成事件中重复发送完整 Task Envelope、步骤注册数据和权限策略。建议把协议分成控制面和数据面:
| 阶段 | 传输内容 | 频率 |
|---|---|---|
| 创建任务 | 最小 Task Envelope、可选已知步骤与动态注册策略 | 每个任务一次 |
| 注册/激活步骤 | 完整 Execution Context、权限、Schema 版本和 Token | 每个 attempt 一次 |
| 上报事件 | 执行句柄、eventId、序号、事件类型和差异数据 | 每次状态变化 |
| 心跳 | 执行句柄和 heartbeatSeq | 高频,可批量或流式 |
对于 REST,首次激活后可以使用高熵、短期有效的 executionHandle 代替重复的任务字段:
POST /internal/v1/task-events
Authorization: Bearer <service-identity-token>
Content-Type: application/json
{
  "executionHandle": "exh_7PKf3uB6S9Qn",
  "eventId": "evt-01JQ...",
  "sourceSeq": 2,
  "eventType": "STEP_COMPLETED",
  "durationMs": 18000,
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {"resultRef": "result://task-8a4d/parse-v2"}
  }
}
状态服务根据句柄解析出 workflowId + taskId + stepId + stepAttempt + executionId + operationCode + producerId,再与 mTLS 或服务身份 Token 以及数据库中的 task→workflow 关系交叉校验。句柄必须不可猜测、绑定生产者、有过期时间,并在步骤终止或权限撤销后失效。可以使用两种实现:
- 自包含签名 Token:状态服务无需额外凭证查询,部署简单,但 JWT/PASETO 一类 Token 相对较长;
- 不透明句柄:线上只传较短随机值,服务端保存其哈希或使用 Redis 缓存映射,缓存未命中回 MySQL;更省带宽,但不能让 Redis 成为唯一权威。
无论采用哪种方案,事件日志里仍保存完整 taskId/stepId/executionId,不能只留下会过期的句柄。来源服务的本地 Outbox 也要保存持久执行身份和原始事件,不能只保存一次 gRPC 连接内的临时编号。
进一步优化的优先级通常是:
- 不重复传 Task Envelope、注册策略和稳定字段,只发送紧凑事件;
- 合并心跳,按窗口覆盖中间进度,只保留必须持久化的关键状态;
- 复用 HTTP/2 或长连接,避免每次重新握手;
- 内部高吞吐链路使用 Protobuf,UUID 以 16 字节表示,枚举使用整数;
- 只有批量载荷明显较大时才启用 gzip/zstd;对单个很小的心跳压缩往往得不偿失;
- 最后再优化字段名,因为数据库事务、同任务行锁、Outbox 写入和通知扇出通常比几个 JSON 字段更早成为瓶颈。
REST 与 gRPC 可以同时支持,但只能有一套业务语义
推荐由统一 Worker SDK 暴露 started/progress/heartbeat/completed/failed,底层根据环境选择 REST 或 gRPC:
| 方式 | 适合场景 | 优点 | 必须注意 |
|---|---|---|---|
| REST 单条事件 | 外部接入、管理命令、低中频状态 | 易调试、易接网关、兼容性好 | 复用连接,重试保持相同 eventId |
| REST 批量 | 多任务心跳、短窗口进度 | 实现简单,显著减少请求数 | 每一项独立返回接受、重复、旧轮次或失败结果 |
| gRPC Unary | 内部服务关键状态事件 | Protobuf 紧凑、强类型、HTTP/2 复用 | 仍要幂等和本地 Outbox,不能依赖 RPC 成功代表业务提交 |
| gRPC 双向流 | 高频进度、心跳和大量并发 execution | 一次建连持续发送,帧开销小,可做流控 | 断线重连后必须重新绑定,不能把内存流当可靠队列 |
gRPC 流可以在连接建立后先绑定长 Token,服务端返回只在该连接内有效的短编号:
BindExecution(executionToken) → streamExecutionKey=17
ReportEvent(key=17, eventId, sourceSeq, eventType, payload)
Heartbeat(key=17, heartbeatSeq)
重连后重新执行 BindExecution,而不是持久化 streamExecutionKey=17。COMPLETED/FAILED 等关键事实仍先写本地 Outbox,再由 SDK 发送;流断开只影响实时性,不能丢失终态。
REST Adapter 和 gRPC Adapter 只负责认证、限流、解码和协议级错误映射,随后都转换为相同的 TaskEventCommand。后面的 Manifest 校验、eventId 幂等、sourceSeq、状态机、MySQL 事务和版本响应必须共用同一个 Application Service。否则很容易出现“REST 拒绝旧 attempt,但 gRPC 接受”的生产事故。
推荐落地顺序是:先以 REST 单条和批量接口建立正确性基线,再从压测中确认序列化、连接或请求数确实成为瓶颈后启用 gRPC。即使两种协议同时开放,对外承诺也保持一致:相同事件无论通过 REST 还是 gRPC 到达,都获得相同的幂等结果和 taskVersion。
3.4 一次多服务任务如何完整传递
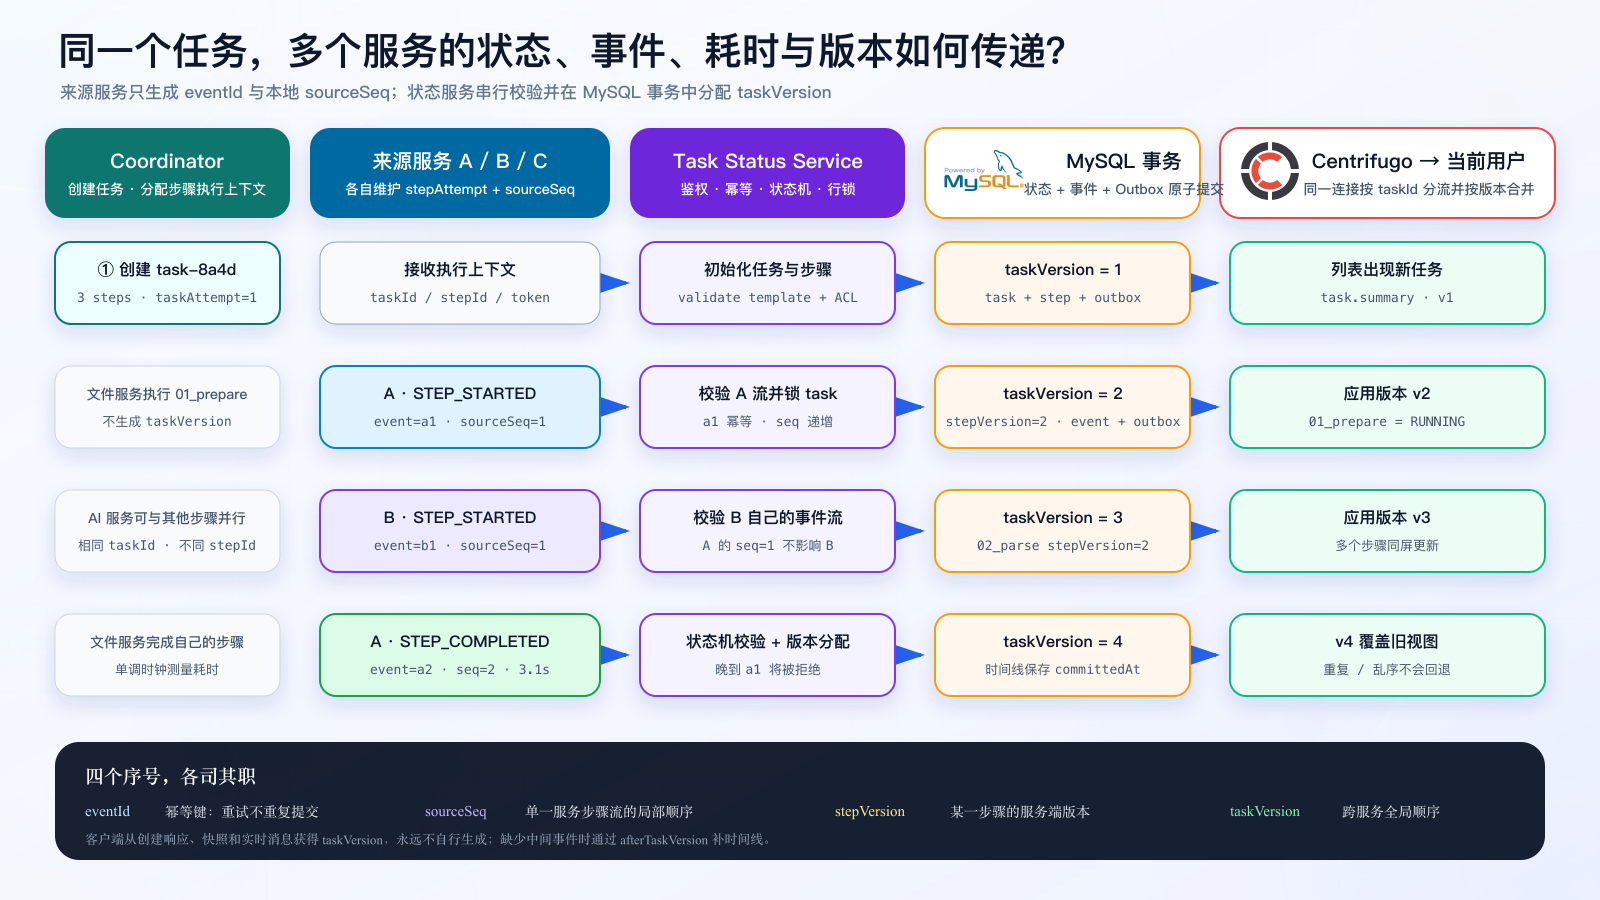
同一个 taskId 下,来源服务只维护自己的 sourceSeq;状态服务在 MySQL 事务里为所有已接受事件分配全局递增的 taskVersion。
假设任务有三个步骤:
01_prepare  FILE.PREPARE     文件服务:准备文件
02_parse    DOCUMENT.PARSE   AI 服务:解析内容
03_store    RESULT.PERSIST   结果服务:保存结果
完整过程如下:
- 这个例子采用固定 Manifest:Coordinator 创建任务和三个待执行步骤,状态服务写入
taskVersion=1并返回稳定taskId;动态模式也可以只创建任务,运行中逐步注册 execution; - 文件服务上报
STEP_STARTED, sourceSeq=1,状态服务接受后分配taskVersion=2; - 文件服务上报
STEP_COMPLETED, sourceSeq=2, durationMs=3100,分配taskVersion=3; - AI 服务上报
STEP_STARTED, sourceSeq=1。它是另一个stepId + producerId,序号可以重新从 1 开始,分配taskVersion=4; - AI 服务可以上报节流后的
STEP_PROGRESS,例如从 35% 到 60%,每个被接受的变化获得新taskVersion; - AI 服务完成后上报
STEP_COMPLETED, durationMs=18000,结果服务再以自己的sourceSeq上报; - Coordinator 确认所有业务收尾完成,最后上报
TASK_COMPLETED,状态服务将生命周期置为SUCCEEDED。
不同服务不共享 sourceSeq 计数器,也不直接生成 taskVersion。它们只对自己的事件流负责,状态服务负责把跨服务并发事件排成一个任务级提交顺序。
这里传递的是状态事实,不是服务间业务结果。服务 A 的文件、模型输出或索引地址仍通过现有工作流、对象存储或业务数据库交给服务 B;状态事件只携带可展示的摘要和不敏感引用。服务之间不互相转发状态,也不经浏览器中转,所有服务都独立上报给 Task Status Service。
3.5 统一事件协议:状态、进度和耗时一起传
推荐使用一个逻辑事件入口,而不是每个服务自定义一套语义。下面展示的是便于调试和跨语言接入的 REST 自描述完整形式;内部高频服务可以采用 3.3.4 节的紧凑 REST 或 gRPC 形式,但最终进入同一个处理器:
POST /internal/v1/task-events
Authorization: Bearer <executionToken>
Idempotency-Key: evt-01JQ...
Content-Type: application/json
{
  "eventId": "evt-01JQ...",
  "taskId": "task-8a4d",
  "taskType": "DOCUMENT_PROCESS",
  "taskAttempt": 1,
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "stepAttempt": 1,
  "producerId": "document-parser",
  "sourceSeq": 2,
  "eventType": "STEP_COMPLETED",
  "businessStatus": "PARSE_COMPLETED",
  "occurredAt": "2026-09-21T07:10:18.120Z",
  "durationMs": 18000,
  "progress": {
    "current": 36,
    "total": 36,
    "unit": "page"
  },
  "data": {
    "schema": "document.parse.completed.v2",
    "value": {
      "pageCount": 36,
      "language": "zh-CN",
      "resultRef": "result://document/task-8a4d/parse-v2"
    }
  }
}
taskType 表达整类任务,operationCode 表达正在执行的功能,eventType 表达这次发生了什么,businessStatus 表达业务现在处于什么阶段,四者不要混用:
eventType | 是否改变状态 | 常用字段 | 说明 |
|---|---|---|---|
STEP_STARTED | 是 | occurredAt | 第一次接受时确定 startedAt |
STEP_PROGRESS | 可选 | progress、message | 应节流、可覆盖,避免高频写入 |
STEP_COMPLETED | 是 | durationMs、data | 映射到成功生命周期 |
STEP_FAILED | 是 | durationMs、error | 错误内容先脱敏再通知客户端 |
STEP_HEARTBEAT | 否 | occurredAt | 只更新健康时间,不等同业务进度 |
STEP_HEALTH_CHANGED | 是 | health、reason | 只允许健康检查器上报,不擅自改业务终态 |
TASK_COMPLETED | 是 | durationMs | 只能由任务协调方上报 |
TASK_FAILED | 是 | error、failedStepId | 只能由任务协调方或注册的失败策略执行器上报 |
普通心跳只更新 lastHeartbeatAt,可以不增加 taskVersion、也不向客户端发布;只有健康状态从 HEALTHY 变成 STALE 或恢复时,Health Reconciler 才提交 STEP_HEALTH_CHANGED 并分配新版本。
3.5.1 中间服务支持心跳,但必须是“任务执行级心跳”
这里需要区分两种完全不同的心跳:
| 心跳 | 回答的问题 | 建议承载方式 | 是否改变用户任务状态 |
|---|---|---|---|
| 服务实例健康检查 | document-parser 这个 Pod 是否还能接流量 | Kubernetes readiness/liveness、服务发现 | 否 |
| 任务执行心跳 | task-8a4d/02_parse/attempt-1 这次执行是否仍在推进 | Task Status Service 心跳接口 | 只在健康状态变化时通知 |
仅有服务级心跳不够:Pod 可能正常响应健康检查,但某个线程、GPU 作业或第三方调用已经卡死。中间服务应为每个长时间运行的步骤独立续租,心跳键至少包含:
taskId + stepId + stepAttempt + executionId
同一服务可以批量上报自己正在执行的多个任务,减少请求和连接开销:
POST /internal/v1/task-heartbeats:batch
Authorization: Bearer <service-identity-token>
Content-Type: application/json
{
  "heartbeats": [
    {
      "taskId": "task-8a4d",
      "stepId": "02_parse",
      "stepAttempt": 1,
      "executionId": "exec-01JQ...",
      "heartbeatSeq": 18,
      "observedAt": "2026-09-21T07:10:45.120Z",
      "executionToken": "short-lived-step-token"
    },
    {
      "taskId": "task-9b5e",
      "stepId": "03_render",
      "stepAttempt": 2,
      "executionId": "exec-01JR...",
      "heartbeatSeq": 7,
      "observedAt": "2026-09-21T07:10:45.140Z",
      "executionToken": "short-lived-step-token"
    }
  ]
}
状态服务逐项校验 Token、当前 attempt、executionId、终态和递增的 heartbeatSeq,并返回每项结果:
{
  "results": [
    {"executionId": "exec-01JQ...", "accepted": true, "health": "HEALTHY"},
    {"executionId": "exec-01JR...", "accepted": false, "reason": "STALE_ATTEMPT"}
  ],
  "receivedAt": "2026-09-21T07:10:45.168Z"
}
心跳判定使用状态服务的 receivedAt,不使用 Worker 的 observedAt 计算超时,避免跨机器时钟偏差。observedAt 只用于排障。推荐规则如下:
- 普通心跳只更新
last_heartbeat_at + last_heartbeat_seq,不写不可变业务事件、不递增taskVersion、不发 WS/SSE; - 同一个 execution 的已接受
STEP_PROGRESS也可以顺便刷新心跳,但不能假设所有功能都会定期产生进度; - 只有
RUNNING且为当前 attempt/execution 的步骤可以续租;终态步骤和旧 attempt 心跳直接拒绝; - Worker 使用带随机抖动的周期发送,短暂上报失败时退避重试,但不能因此中断正在执行的业务;
heartbeatIntervalSeconds=15、heartbeatTimeoutSeconds=60只是示例,应按任务时长、网络抖动和允许的故障发现时间配置,超时通常至少覆盖 3~4 个心跳周期。
Health Reconciler 周期扫描超时步骤,并在行锁内再次确认“仍是当前 execution、仍为 RUNNING、心跳时间没有推进”,然后才提交健康变化:
从 HEALTHY → STALE 或 STALE → HEALTHY 时,状态服务写入 STEP_HEALTH_CHANGED、增加步骤与任务版本,并通过用户摘要和任务详情频道通知客户端。STALE 只表示“暂时无法确认执行器状态”,不能由 Reconciler 自动改成 FAILED;超过更长的升级阈值后,由 Coordinator 结合 failurePolicy 决定继续等待、创建新 attempt、取消还是失败。
如果 Worker 在任务上报前彻底崩溃,最终一定会缺少心跳;如果只是状态服务短暂不可用,则多个 Worker 可能同时出现心跳空洞。因此 Reconciler 要有宽限期、批量限速和切换抑制,状态服务/MySQL 故障期间不能制造大面积假 STALE。
状态服务的响应必须把最终接受结果和版本返回给调用方:
{
  "accepted": true,
  "duplicate": false,
  "stale": false,
  "taskId": "task-8a4d",
  "stepId": "02_parse",
  "operationCode": "DOCUMENT.PARSE",
  "taskVersion": "12",
  "stepVersion": "4",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSE_COMPLETED",
  "committedAt": "2026-09-21T07:10:18.156Z"
}
请求超时后,生产服务使用相同 eventId 和相同内容重试。状态服务从幂等表返回第一次提交的同一个 taskVersion,不能再次递增。
3.6 七种序号和版本到底分别从哪里来
这里有七种容易混淆但用途完全不同的序号或版本:
| 字段 | 产生或绑定方 | 作用范围 | 主要用途 |
|---|---|---|---|
schemaVersion | 实时协议发布方 | 消息格式 | 判断公共 JSON 信封如何解析 |
statusDefinitionVersion | 创建时或后续分类命令绑定 | 任务绑定后生命周期 | 固定业务状态代码与生命周期的映射;未分类时可为空 |
operationDefinitionVersion | execution 注册时由服务端绑定 | 单个 execution | 固定功能、生产者、数据 Schema 与失败策略 |
data.schema | 来源服务从允许集合选择,服务端校验 | 单类功能数据 | 判断 data.value 的具体结构与兼容版本 |
sourceSeq | 来源服务生成 | 单个步骤执行流 | 拒绝同一来源的乱序旧事件 |
stepVersion | 状态服务生成 | 单个 taskId + stepId | 合并某一步骤的快照与消息 |
taskVersion | 状态服务生成 | 整个任务 | 跨多个服务建立统一提交顺序 |
版本在 MySQL 事务中分配。伪代码如下:
START TRANSACTION;

SELECT workflow_id, version, attempt, lifecycle_status
FROM task
WHERE id = :task_id
FOR UPDATE;

SELECT version, attempt AS step_attempt, source_seq, lifecycle_status
FROM task_step
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
FOR UPDATE;

-- 应用进程在持有行锁时完成:
-- 1. eventId 幂等检查
-- 2. executionToken / attempt / sourceSeq / 状态机校验
-- 3. new_task_version = current_task_version + 1
-- 4. new_step_version = current_step_version + 1

UPDATE task_step
SET version = :new_step_version,
    source_seq = :source_seq,
    lifecycle_status = :step_lifecycle,
    business_status = :business_status,
    updated_at = UTC_TIMESTAMP(3)
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt;

UPDATE task
SET version = :new_task_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE id = :task_id;

INSERT INTO task_event_log (..., task_version, step_version, ...)
VALUES (..., :new_task_version, :new_step_version, ...);

INSERT INTO task_outbox (..., aggregate_type, aggregate_version, payload)
VALUES (..., 'TASK', :new_task_version, :complete_state_json);

COMMIT;
如果服务 A 和服务 B 同时上报,二者会竞争同一 task 行锁:先提交的事件得到 taskVersion=12,后提交的得到 taskVersion=13。这不是要求服务之间同步时钟,而是以数据库提交顺序为任务建立稳定总序。某个超热门任务可能因此成为单行热点,但普通异步任务的状态变化频率通常远低于业务数据吞吐;确有证据时再把步骤事件流与任务摘要版本拆分。
3.7 事件耗时如何得到,哪些时间可以相信
每个时间字段回答不同问题:
| 字段 | 产生位置 | 用途 |
|---|---|---|
occurredAt | 来源服务墙钟 | 展示业务事件大致发生时间 |
receivedAt | 状态服务 | 观察网络与排队延迟 |
committedAt | MySQL 事务提交附近 | 定义该版本何时成为事实 |
durationMs | 来源服务单调时钟 | 精确表示该次执行耗时 |
步骤开始时,来源服务记录单调时钟起点,并上报 STEP_STARTED;结束时用同一进程的单调时钟计算 durationMs。不要用两台机器的 finishedAt - startedAt 计算精确执行耗时,因为 NTP 偏差、休眠和时钟回拨都会污染结果。
状态服务同时保存三类耗时:
queueDurationMs = startedAt - createdAt       排队等待
runDurationMs   = Worker 上报的 durationMs    实际执行
totalDurationMs = task committed terminal - task createdAt
对于进程重启导致单调时钟起点丢失的情况,Worker 应从自己的持久化执行记录恢复;确实无法恢复时把 durationSource 标记为 WALL_CLOCK_ESTIMATE,而不是伪装成精确值。
3.8 客户端怎样获得版本和事件时间线
客户端有三种版本来源,取最大值合并:
创建任务响应:taskVersion=1
快照接口响应:taskVersion=11, 各 stepVersion
实时消息:    taskVersion=12
推荐快照接口:
GET /api/tasks/task-8a4d
GET /api/tasks/task-8a4d/events?afterTaskVersion=8&limit=100
快照返回当前完整状态,事件接口返回用于时间线展示的已提交事件。实时 task.detail 消息同时带 triggerEvent 和完整当前状态:事件区可以追加时间线,状态区只接受更高版本。
{
  "kind": "task.detail",
  "taskVersion": "12",
  "triggerEvent": {
    "eventId": "evt-01JQ...",
    "eventType": "STEP_COMPLETED",
    "stepId": "02_parse",
    "operationCode": "DOCUMENT.PARSE",
    "durationMs": 18000,
    "data": {
      "schema": "document.parse.completed.v2",
      "value": {"pageCount": 36, "language": "zh-CN"}
    },
    "committedAt": "2026-09-21T07:10:18.156Z"
  },
  "state": {
    "taskType": "DOCUMENT_PROCESS",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "PARSE_COMPLETED",
    "steps": []
  }
}
如果实时消息从版本 9 直接跳到 12,不代表一定丢失了当前状态,因为消息携带完整快照;如果 UI 还要展示每一个中间事件,再调用 events?afterTaskVersion=9 补时间线。当前状态恢复和审计事件补齐是两个不同问题。
3.9 总任务完成
总任务终态应由现有业务协调方明确上报:
{
  "eventId": "019a-task-final-001",
  "taskId": "task-8a4d",
  "taskAttempt": 1,
  "producerId": "task-coordinator",
  "sourceSeq": 7,
  "eventType": "TASK_COMPLETED",
  "businessStatus": "COMPLETED",
  "durationMs": 42600
}
不要让状态服务根据“当前登记的步骤都成功”自动推导总任务成功。真实业务可能还在保存结果、生成索引、写审计记录,甚至下一步尚未登记。只有当工作流定义固定、完整且由状态服务权威管理时,才适合做状态聚合推导。
四、状态机:允许什么,拒绝什么
4.1 推荐状态集合
PENDING    已创建,尚未开始
RUNNING    正在执行
SUCCEEDED  成功终止
FAILED     失败终止
CANCELLED  取消终止
如果业务明确区分超时,可以增加 TIMED_OUT;如果只是展示“执行器可能失联”,更适合增加独立的健康字段,而不是把业务状态直接改成失败。
重试不是把同一个 attempt=1 从 FAILED 改回 RUNNING,而是由协调方创建 attempt=2。这能保留“第一次失败、第二次成功”的事实,也让晚到的第一次完成消息无法污染第二轮。
4.2 终态不可被普通事件覆盖
同一轮次中,下面的变化都应拒绝:
SUCCEEDED → RUNNING
FAILED    → SUCCEEDED
CANCELLED → RUNNING
如果业务确实需要人工纠错,不应伪装成普通 Worker 上报。应设计独立的管理员纠错命令,记录操作者、原因、旧值、新值和审计时间,并产生新的业务版本。
4.3 业务状态与健康状态分离
{
  "lifecycleStatus": "RUNNING",
  "health": "STALE",
  "lastHeartbeatAt": "2026-09-21T07:11:00Z"
}
lifecycleStatus=RUNNING:最后一个已确认的业务事实是正在运行;health=STALE:一段时间未观察到执行端心跳;- UI 显示“运行中,状态待确认”,而不是擅自改成“失败”。
连接断开、Worker 心跳超时和任务失败是三件不同的事。把它们混成一个状态,会制造大量假失败。
4.4 异常不是一个字符串:失败、失联和通知故障分别建模
异常至少分成四类,处理主体和用户文案都不同:
| 异常类型 | 谁确认 | 状态如何变化 | 用户应该看到什么 |
|---|---|---|---|
| 业务执行失败 | 当前步骤 Worker 上报 STEP_FAILED | 当前步骤 attempt 进入 FAILED | “文档解析失败:文件格式不受支持” |
| 可重试步骤失败 | Worker + Coordinator | 本 attempt 为 FAILED,任务可保持 RUNNING/RETRY_WAIT,随后创建新 attempt | “解析失败,正在进行第 2 次重试” |
| Worker 心跳超时 | Health Reconciler | health=STALE,生命周期仍保留最后已确认值 | “仍在运行,但暂时无法确认执行器状态” |
| 状态上报或实时通知故障 | 来源 Outbox / Relay / 客户端恢复机制 | 不制造业务 FAILED | “实时更新暂不可用”,恢复后读取快照 |
步骤失败时建议使用结构化错误,而不是让每个服务随意拼接一段异常栈:
{
  "eventType": "STEP_FAILED",
  "operationCode": "DOCUMENT.PARSE",
  "businessStatus": "PARSE_FAILED",
  "durationMs": 18240,
  "error": {
    "category": "BUSINESS_INPUT",
    "code": "UNSUPPORTED_FILE_FORMAT",
    "retryable": false,
    "userMessage": "暂不支持该文件格式,请转换为 PDF 后重试",
    "diagnosticsRef": "trace://01JQ7M..."
  }
}
code是稳定的机器可读错误码,驱动前端操作按钮和统计;userMessage必须可安全展示且经过长度限制、脱敏和国际化映射;diagnosticsRef只给服务端排障使用,客户端不能凭它读取日志;- 原始堆栈、SQL、对象存储地址、密钥和第三方响应不能进入实时消息。
步骤失败不一定意味着总任务立即失败。每个 operationCode 在功能定义中声明 failurePolicy:
FAIL_TASK              关键步骤失败,由 Coordinator 明确提交 TASK_FAILED
RETRY_THEN_FAIL_TASK   先创建新 attempt,耗尽重试后提交 TASK_FAILED
CONTINUE_WITH_WARNING  可选步骤失败,任务继续但 health=DEGRADED
WAIT_FOR_USER          任务保持 RUNNING,businessStatus=WAITING_USER_ACTION
状态服务可以校验策略,但总任务终态仍应由 Coordinator 或明确注册的策略执行器提交。它不能仅凭“看到一个步骤失败”猜测任务失败,因为该步骤可能可选、可补偿或正在重试。
4.5 允许业务自定义状态,但不要让它接管生命周期
不同产品需要不同的展示语义。例如文档任务可能经历“正在 OCR”“等待人工复核”,视频任务可能经历“正在渲染”“正在上传”。如果把这些值全部塞进通用状态机,每接入一个业务都要修改状态服务、客户端和告警规则。
更稳妥的模型是同时保存两套状态:
| 字段 | 示例 | 作用 |
|---|---|---|
lifecycleStatus | RUNNING | 跨业务稳定,驱动终态判断、重试、耗时和告警 |
businessStatus | WAITING_REVIEW | 业务自定义,驱动标题、说明、进度阶段和视觉呈现 |
phaseCode | OCR_PAGE | 可选的细粒度中间阶段;允许动态出现,但不参与生命周期决策 |
statusDefinitionVersion | 3 或 null | 已分类任务固定定义版本;未分类任务可为空 |
health | STALE | 描述执行端健康,不改写已确认的业务事实 |
例如:
{
  "taskId": "8a4d",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "WAITING_REVIEW",
  "statusDefinitionVersion": 3,
  "health": "HEALTHY",
  "version": "12"
}
真正驱动业务规则的 businessStatus 只能使用已经注册的代码。服务端根据任务类型与定义版本解析出它对应的生命周期,并校验允许的来源状态:
DOCUMENT_PROCESS / v3

QUEUED          → lifecycle=PENDING
PARSING         → lifecycle=RUNNING
WAITING_REVIEW  → lifecycle=RUNNING
PUBLISHING      → lifecycle=RUNNING
COMPLETED       → lifecycle=SUCCEEDED, terminal=true
REJECTED        → lifecycle=FAILED,    terminal=true
调用方不能自行声明 terminal=true,也不能决定颜色、严重级别或对应的生命周期,否则一个拼错或恶意字段就可能绕过终态保护。未知 businessStatus 应拒绝写入;但未知 phaseCode 可以在字符集、长度、频率和 payload 大小限制内作为普通进度元数据保存,客户端用通用阶段文案降级展示。换句话说:允许动态中间阶段,不允许动态发明终态语义。
当 taskType 创建时未知,任务先使用通用生命周期 PENDING/RUNNING/SUCCEEDED/FAILED/CANCELLED,statusDefinitionVersion=null。Coordinator 后续可以使用带版本条件的分类命令绑定任务类型和定义版本:
PATCH /internal/v1/tasks/task-8a4d/classification
If-Match: "task-version-4"
{
  "productId": "knowledge-assistant",
  "taskType": "DYNAMIC_RESEARCH",
  "statusDefinitionVersion": 3,
  "operationDefinitionVersion": 2
}
taskType 与定义版本一旦被需要业务语义的状态或步骤引用就冻结;productId 仍然只是可为空、可审计修改的分类标签。状态服务把分类变化写成 TASK_CLASSIFIED 或 TASK_METADATA_UPDATED 事件并增加 taskVersion,避免客户端悄悄看到含义变化。
4.6 自定义状态注册表
状态定义按租户、安全命名空间和任务类型配置,不要求任务创建时就存在 productId。定义变更必须版本化:
CREATE TABLE task_status_definition (
  tenant_id CHAR(36) NOT NULL COMMENT '租户 ID',
  authority_scope VARCHAR(64) NOT NULL COMMENT '从认证身份确定的不可变安全命名空间',
  task_type VARCHAR(128) NOT NULL COMMENT '任务类型',
  definition_version INT UNSIGNED NOT NULL COMMENT '业务状态定义版本',
  code VARCHAR(64) NOT NULL COMMENT '业务状态编码',
  display_name VARCHAR(128) NOT NULL COMMENT '默认展示名称',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '映射到的系统生命周期状态',
  terminal BOOLEAN NOT NULL DEFAULT FALSE COMMENT '该业务状态是否表示终态',
  severity VARCHAR(16) NOT NULL DEFAULT 'INFO' COMMENT '展示与告警严重级别',
  sort_order INT NOT NULL DEFAULT 0 COMMENT '同类状态的展示顺序',
  presentation JSON NULL COMMENT '颜色、图标和国际化文案键等展示元数据',
  allowed_from JSON NOT NULL COMMENT '允许迁移到当前状态的前置业务状态集合',
  enabled BOOLEAN NOT NULL DEFAULT TRUE COMMENT '状态定义是否允许用于新事件',
  PRIMARY KEY (
    tenant_id, authority_scope, task_type, definition_version, code
  )
) ENGINE=InnoDB COMMENT='租户、安全命名空间和任务类型维度的版本化业务状态定义';
presentation 只保存诸如 colorToken、iconKey 和本地化文案键等展示元数据,不保存任意 HTML。任务可以稍后绑定 definition_version,但绑定后不能随配置更新漂移;发布新版定义不会悄悄改变正在运行或历史任务的含义。
4.7 功能定义注册表:限制谁能上报什么、下发什么
operationCode 不能在普通事件中成为完全无约束的字符串。预定义步骤在模板中引用功能定义,动态步骤在注册时选择功能定义或受限的通用 Profile;状态服务据此校验生产者、事件类型、差异化数据 Schema 和失败策略:
CREATE TABLE task_operation_definition (
  tenant_id CHAR(36) NOT NULL COMMENT '租户 ID',
  authority_scope VARCHAR(64) NOT NULL COMMENT '从认证身份确定的不可变安全命名空间',
  task_type_pattern VARCHAR(128) NOT NULL DEFAULT '*' COMMENT '适用任务类型,星号表示未分类任务也可使用',
  definition_version INT UNSIGNED NOT NULL COMMENT '功能定义版本',
  operation_code VARCHAR(128) NOT NULL COMMENT '稳定的业务功能编码',
  display_name VARCHAR(128) NOT NULL COMMENT '功能默认展示名称',
  producer_pattern VARCHAR(255) NOT NULL COMMENT '允许上报该功能的服务身份模式',
  allowed_event_types JSON NOT NULL COMMENT '允许该功能提交的事件类型集合',
  allowed_data_schemas JSON NOT NULL COMMENT '各事件允许使用的数据 Schema 集合',
  failure_policy VARCHAR(32) NOT NULL COMMENT '失败后的任务级处理策略',
  enabled BOOLEAN NOT NULL DEFAULT TRUE COMMENT '是否允许用于新任务',
  PRIMARY KEY (
    tenant_id, authority_scope, task_type_pattern,
    definition_version, operation_code
  )
) ENGINE=InnoDB COMMENT='任务功能、上报权限、数据契约与失败策略定义';
例如 DOCUMENT.PARSE 可以允许 document.parse.progress.v1 和 document.parse.completed.v2,但拒绝 video.transcode.progress.v1;producerId=document-parser 也不能给 RESULT.PERSIST 上报。动态通用 Profile 可以允许 STEP_PROGRESS + generic.progress.v1 和自由 phaseCode,但不能允许 Worker 提交任务终态。每个 execution 在注册时固定 operation_definition_version,从而避免运行途中配置更新导致同一事件突然改变解释方式。
五、MySQL 数据模型:当前状态、幂等和 Outbox
第一版可以使用 workflow、任务、步骤、不可变事件、事件幂等和 Outbox 六张运行时核心表,外加上一节的版本化状态定义表与功能定义表。共享任务可再增加 ACL 关联表,接入外部业务编号时可增加外部引用映射表;它们负责“谁能看到哪些 taskId”和“外部编号对应哪个 canonical taskId”,不参与单任务状态机。下面以 MySQL 8.0 和 InnoDB 为基线,为了便于阅读使用 CHAR(36) 保存 UUID;高写入量场景可以改为 BINARY(16),但必须统一字节序和序列化规则。
CREATE TABLE workflow (
  id CHAR(36) NOT NULL COMMENT '顶层业务流程全局唯一 ID,即 workflowId',
  tenant_id CHAR(36) NOT NULL COMMENT 'workflow 所属租户 ID',
  owner_id CHAR(36) NOT NULL COMMENT 'workflow 创建者或默认所有者 ID',
  authority_scope VARCHAR(64) NOT NULL COMMENT '认证身份确定且创建后不可变的安全命名空间',
  client_workflow_key VARCHAR(128) NOT NULL COMMENT '调用方提供的 workflow 幂等创建键',
  workflow_type VARCHAR(128) NULL COMMENT '可选顶层流程类型,创建时未知可以为空',
  title VARCHAR(255) NOT NULL COMMENT '顶层流程展示标题',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT 'workflow 显式或聚合得到的生命周期状态',
  version BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT 'workflow 成员关系和聚合视图的单调版本',
  task_count INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '当前已注册独立任务数量',
  created_at DATETIME(3) NOT NULL COMMENT 'workflow 创建时间',
  started_at DATETIME(3) NULL COMMENT 'workflow 首次进入运行态的时间',
  finished_at DATETIME(3) NULL COMMENT 'workflow 进入权威终态的时间',
  updated_at DATETIME(3) NOT NULL COMMENT 'workflow 元数据或聚合视图最后更新时间',
  PRIMARY KEY (id),
  UNIQUE KEY workflow_client_key_uk
    (tenant_id, authority_scope, client_workflow_key),
  KEY workflow_owner_updated_idx
    (tenant_id, owner_id, updated_at DESC, id)
) ENGINE=InnoDB COMMENT='顶层业务流程、任务成员关系入口与独立 workflow 版本';

CREATE TABLE task (
  id CHAR(36) NOT NULL COMMENT '任务全局唯一 ID',
  workflow_id CHAR(36) NOT NULL COMMENT '所属顶层业务流程 ID',
  client_task_key VARCHAR(128) NOT NULL COMMENT '同一 workflow 内幂等创建任务的调用方键',
  tenant_id CHAR(36) NOT NULL COMMENT '任务所属租户 ID',
  owner_id CHAR(36) NOT NULL COMMENT '任务所属用户 ID',
  authority_scope VARCHAR(64) NOT NULL COMMENT '认证身份确定且创建后不可变的安全命名空间',
  product_id VARCHAR(64) NULL COMMENT '可为空且可审计更新的产品分类标签,不参与鉴权和分片',
  task_type VARCHAR(128) NULL COMMENT '任务类型,创建时未知可为空,绑定业务定义后冻结',
  batch_id CHAR(36) NULL COMMENT '可选批次 ID,用于把多个独立任务聚合展示',
  parent_task_id CHAR(36) NULL COMMENT '可选父任务 ID,父子任务仍各自拥有独立版本和终态',
  title VARCHAR(255) NOT NULL COMMENT '面向用户展示的任务标题',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '系统生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '业务自定义状态编码',
  status_definition_version INT UNSIGNED NULL COMMENT '任务完成业务分类后绑定的状态定义版本',
  operation_definition_version INT UNSIGNED NULL COMMENT '任务级默认功能定义版本,动态 execution 可单独固定版本',
  attempt INT UNSIGNED NOT NULL DEFAULT 1 COMMENT '任务级执行轮次',
  coordinator_source_seq BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT 'Coordinator 任务级事件序号',
  version BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '状态服务分配的任务级单调版本',
  health VARCHAR(16) NOT NULL DEFAULT 'HEALTHY' COMMENT 'HEALTHY、DEGRADED 或 STALE',
  summary_schema VARCHAR(128) NULL COMMENT '任务列表差异化摘要数据的 Schema',
  summary_data JSON NULL COMMENT '经过白名单裁剪的任务列表差异化摘要数据',
  failure_code VARCHAR(128) NULL COMMENT '任务级稳定失败码',
  failure_message VARCHAR(512) NULL COMMENT '面向用户且已脱敏的任务失败说明',
  failed_step_id VARCHAR(128) NULL COMMENT '导致任务失败的步骤 ID',
  created_at DATETIME(3) NOT NULL COMMENT '任务创建时间',
  started_at DATETIME(3) NULL COMMENT '任务首次进入运行态的时间',
  finished_at DATETIME(3) NULL COMMENT '任务进入权威终态的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '任务最终确认耗时,单位毫秒',
  updated_at DATETIME(3) NOT NULL COMMENT '任务状态最后提交时间',
  PRIMARY KEY (id),
  UNIQUE KEY task_workflow_client_key_uk
    (workflow_id, client_task_key),
  KEY task_workflow_updated_idx
    (workflow_id, updated_at DESC, id),
  KEY task_owner_updated_idx
    (tenant_id, owner_id, updated_at DESC, id),
  KEY task_batch_idx
    (tenant_id, batch_id, created_at, id),
  KEY task_parent_idx
    (tenant_id, parent_task_id, created_at, id)
) ENGINE=InnoDB COMMENT='任务当前权威状态与任务级版本';

CREATE TABLE task_step (
  task_id CHAR(36) NOT NULL COMMENT '所属任务 ID',
  step_id VARCHAR(128) NOT NULL COMMENT '任务内稳定的步骤 ID',
  client_step_key VARCHAR(128) NOT NULL COMMENT '协调方提供的幂等步骤键,动态注册重试保持不变',
  parent_execution_id CHAR(36) NULL COMMENT '动态子步骤的父执行实例 ID,主干步骤可为空',
  operation_code VARCHAR(128) NOT NULL COMMENT '该步骤执行的稳定业务功能编码',
  operation_definition_version INT UNSIGNED NOT NULL COMMENT '该 execution 注册时固定的功能定义或通用 Profile 版本',
  service_name VARCHAR(128) NOT NULL COMMENT '负责执行并上报状态的服务名',
  attempt INT UNSIGNED NOT NULL COMMENT '步骤执行轮次',
  execution_id CHAR(36) NULL COMMENT '步骤激活后绑定的实际执行实例 ID,等待态可为空',
  source_seq BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '当前服务在本步骤轮次内的单调事件序号',
  version BIGINT UNSIGNED NOT NULL DEFAULT 1 COMMENT '状态服务分配的步骤级单调版本',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '步骤生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '步骤业务自定义状态编码',
  health VARCHAR(16) NOT NULL DEFAULT 'HEALTHY' COMMENT '步骤执行器的健康状态',
  heartbeat_interval_seconds SMALLINT UNSIGNED NULL COMMENT '约定的任务执行心跳间隔秒数',
  heartbeat_timeout_seconds SMALLINT UNSIGNED NULL COMMENT '判定任务执行心跳超时的秒数',
  last_heartbeat_seq BIGINT UNSIGNED NOT NULL DEFAULT 0 COMMENT '当前 execution 已接受的最大心跳序号',
  last_heartbeat_at DATETIME(3) NULL COMMENT '最近一次已接受心跳时间',
  stale_since DATETIME(3) NULL COMMENT '当前 execution 首次被判定为 STALE 的时间',
  data_schema VARCHAR(128) NULL COMMENT '当前功能特有状态数据的 Schema',
  state_data JSON NULL COMMENT '经过校验和裁剪的功能特有当前状态数据',
  started_at DATETIME(3) NULL COMMENT '步骤开始时间',
  finished_at DATETIME(3) NULL COMMENT '步骤进入终态的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '执行服务用单调时钟测得的耗时,单位毫秒',
  error_category VARCHAR(64) NULL COMMENT '业务输入、依赖、系统等错误分类',
  error_code VARCHAR(128) NULL COMMENT '稳定的机器可读错误码',
  error_message TEXT NULL COMMENT '脱敏后的错误说明',
  error_retryable BOOLEAN NULL COMMENT '该步骤失败是否允许重试',
  diagnostics_ref VARCHAR(255) NULL COMMENT '仅供服务端排障关联的诊断引用',
  updated_at DATETIME(3) NOT NULL COMMENT '步骤状态最后提交时间',
  PRIMARY KEY (task_id, step_id, attempt),
  UNIQUE KEY task_step_client_key_uk
    (task_id, client_step_key, attempt),
  UNIQUE KEY task_step_execution_uk (execution_id),
  KEY task_step_heartbeat_idx
    (lifecycle_status, health, last_heartbeat_at),
  CONSTRAINT task_step_task_fk
    FOREIGN KEY (task_id) REFERENCES task(id)
) ENGINE=InnoDB COMMENT='每个任务步骤及执行轮次的当前权威状态';

CREATE TABLE task_event_log (
  event_id CHAR(36) NOT NULL COMMENT '生产者生成的全局幂等事件 ID',
  workflow_id CHAR(36) NOT NULL COMMENT '所属顶层业务流程 ID,便于审计和投影归组',
  task_id CHAR(36) NOT NULL COMMENT '所属任务 ID',
  task_version BIGINT UNSIGNED NOT NULL COMMENT '该事件提交后获得的任务级版本',
  step_id VARCHAR(128) NULL COMMENT '步骤事件对应的步骤 ID,任务级事件为空',
  operation_code VARCHAR(128) NULL COMMENT '步骤事件对应的业务功能编码',
  execution_id CHAR(36) NULL COMMENT '步骤事件对应的实际执行实例 ID',
  step_version BIGINT UNSIGNED NULL COMMENT '该事件提交后获得的步骤级版本',
  task_attempt INT UNSIGNED NOT NULL COMMENT '事件所属任务执行轮次',
  step_attempt INT UNSIGNED NULL COMMENT '事件所属步骤执行轮次',
  producer_id VARCHAR(128) NOT NULL COMMENT '事件生产服务或协调器标识',
  source_seq BIGINT UNSIGNED NOT NULL COMMENT '生产者在对应执行流内的单调序号',
  event_type VARCHAR(64) NOT NULL COMMENT '事件类型,例如 STEP_STARTED',
  lifecycle_status VARCHAR(32) NOT NULL COMMENT '事件提交后的生命周期状态',
  business_status VARCHAR(64) NOT NULL COMMENT '事件提交后的业务状态编码',
  health VARCHAR(16) NOT NULL COMMENT '事件提交后的健康状态',
  data_schema VARCHAR(128) NULL COMMENT '功能特有数据的 Schema',
  error_code VARCHAR(128) NULL COMMENT '该事件携带的稳定错误码',
  occurred_at DATETIME(3) NOT NULL COMMENT '事件在生产者侧发生的墙钟时间',
  received_at DATETIME(3) NOT NULL COMMENT '状态服务接收到事件的时间',
  committed_at DATETIME(3) NOT NULL COMMENT '事件在 MySQL 中提交的时间',
  duration_ms BIGINT UNSIGNED NULL COMMENT '生产者测量的事件或步骤耗时,单位毫秒',
  payload JSON NULL COMMENT '审计和回放所需的扩展事件数据',
  PRIMARY KEY (event_id),
  UNIQUE KEY task_event_version_uk (task_id, task_version),
  KEY task_event_timeline_idx (task_id, committed_at, event_id),
  UNIQUE KEY task_step_event_seq_uk
    (task_id, step_id, step_attempt, source_seq)
) ENGINE=InnoDB COMMENT='已接受状态事件的不可变时间线与版本审计记录';

CREATE TABLE task_event_dedup (
  event_id CHAR(36) NOT NULL COMMENT '生产者生成的全局幂等事件 ID',
  task_id CHAR(36) NOT NULL COMMENT '事件所属任务 ID',
  payload_hash CHAR(64) NOT NULL COMMENT '规范化事件内容的 SHA-256 摘要',
  result JSON NOT NULL COMMENT '首次处理结果,包含已分配版本等响应字段',
  created_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '首次处理并记录幂等结果的时间',
  PRIMARY KEY (event_id),
  KEY task_event_task_idx (task_id, created_at)
) ENGINE=InnoDB COMMENT='事件幂等判定与首次响应结果缓存';

CREATE TABLE task_acl (
  task_id CHAR(36) NOT NULL COMMENT '被授权访问的任务 ID',
  principal_type VARCHAR(16) NOT NULL COMMENT 'USER、PROJECT 或 ROLE',
  principal_id CHAR(36) NOT NULL COMMENT '用户、项目或角色 ID',
  permission VARCHAR(16) NOT NULL COMMENT 'VIEW、OPERATE 或 ADMIN',
  created_at DATETIME(3) NOT NULL COMMENT '授权创建时间',
  revoked_at DATETIME(3) NULL COMMENT '授权撤销时间,为空表示当前有效',
  PRIMARY KEY (task_id, principal_type, principal_id),
  KEY task_acl_principal_idx
    (principal_type, principal_id, revoked_at, task_id),
  CONSTRAINT task_acl_task_fk
    FOREIGN KEY (task_id) REFERENCES task(id)
) ENGINE=InnoDB COMMENT='任务与用户、项目或角色之间的访问授权关系';

CREATE TABLE task_external_ref (
  tenant_id CHAR(36) NOT NULL COMMENT '租户 ID',
  authority_scope VARCHAR(64) NOT NULL COMMENT '外部编号所属的安全命名空间',
  ref_type VARCHAR(64) NOT NULL COMMENT '外部编号类型,例如 ORDER_ID',
  ref_value VARCHAR(255) NOT NULL COMMENT '外部系统中的稳定编号',
  task_id CHAR(36) NOT NULL COMMENT '映射到的 canonical taskId',
  created_at DATETIME(3) NOT NULL COMMENT '映射创建时间',
  PRIMARY KEY (tenant_id, authority_scope, ref_type, ref_value),
  KEY task_external_ref_task_idx (task_id),
  CONSTRAINT task_external_ref_task_fk
    FOREIGN KEY (task_id) REFERENCES task(id)
) ENGINE=InnoDB COMMENT='外部业务编号到 canonical taskId 的唯一映射';
workflow.version 和 task.version 是两套独立水位。workflow 新增或移除任务、标题变化、或者聚合器确认整体状态变化时才递增 workflow.version;task 内部事件只直接递增该任务的 task.version。如果产品要展示整体进度,由投影器读取各任务当前态并生成新的 workflow.summary,不能拿最大的 taskVersion 冒充 workflowVersion。
task.id 仍需全局唯一,UNIQUE(workflow_id, client_task_key) 只负责保证同一 workflow 下的任务创建重试不会重复生成 task。示例有意不在 task.workflow_id 上声明数据库外键:单库部署可以增加外键,但按 task 分库后 workflow 与 task 可能不在同一物理库,届时应由状态服务在创建命令中校验 workflow、租户和安全域,并用幂等成员索引保证引用完整性。
任务创建者通过 task.owner_id 进入个人摘要;共享任务则通过未撤销的 task_acl 把同一个 taskId 投影给其他用户、项目成员或角色。workflow 的拥有者并不天然获得所有任务详情:创建子任务时要根据 workflow 策略把有效授权固化为 task ACL,敏感任务可以进一步收窄。授权和撤销都应写入对应用户摘要的 Outbox:授权时发布当前摘要,撤销时发布 task.removed 或 tombstone,让客户端立即移除本地任务。productId 只用于分类,永远不能据此授予访问权限。
如果任务按 taskId 分库,用户的跨任务列表由第 15.5 节的 user_task_index 有界读模型承担;不能为了找出某个用户的全部 taskId,在在线请求中扫描所有物理分片。
task.coordinator_source_seq 只排序 Coordinator 产生的任务级事件;每个服务的步骤事件分别使用对应 task_step.source_seq。不能拿一个任务级 source_seq 比较所有服务,否则文件服务的 seq=2 会错误地把 AI 服务合法的 seq=1 当成旧消息。
5.1 MySQL Outbox 表
Centrifugo 当前的内置异步消费者列表没有 MySQL。因此这里不让 Centrifugo 直接扫描数据库,而是由独立的 Outbox Relay 从 MySQL 领取记录,再调用 Centrifugo HTTP 或 gRPC Server API。官方支持的内置消费者及自定义 consumer 接入边界见 Built-in API command async consumers。
CREATE TABLE task_outbox (
  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT COMMENT 'Outbox 自增主键',
  aggregate_type VARCHAR(16) NOT NULL COMMENT 'WORKFLOW 或 TASK,区分两种独立版本域',
  aggregate_id CHAR(36) NOT NULL COMMENT 'workflowId 或 taskId 聚合根 ID',
  aggregate_version BIGINT UNSIGNED NOT NULL COMMENT '消息对应的 workflowVersion 或 taskVersion',
  channel VARCHAR(255) NOT NULL COMMENT '服务端计算出的 Centrifugo 目标频道',
  projection VARCHAR(32) NOT NULL COMMENT 'USER_SUMMARY、TASK_DETAIL 或广播投影类型',
  payload JSON NOT NULL COMMENT '包含完整任务状态的发布载荷',
  status VARCHAR(16) NOT NULL DEFAULT 'PENDING' COMMENT 'PENDING、PROCESSING、PUBLISHED 或 DEAD',
  available_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT '允许 Relay 下一次领取的时间',
  locked_by VARCHAR(128) NULL COMMENT '当前领取该记录的 Relay 实例 ID',
  locked_at DATETIME(3) NULL COMMENT 'Relay 获得领取租约的时间',
  attempts INT UNSIGNED NOT NULL DEFAULT 0 COMMENT '累计发布尝试次数',
  last_error VARCHAR(1024) NULL COMMENT '最近一次脱敏后的发布错误',
  created_at DATETIME(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3) COMMENT 'Outbox 记录创建时间',
  published_at DATETIME(3) NULL COMMENT '最近一次成功发布时间',
  PRIMARY KEY (id),
  UNIQUE KEY outbox_aggregate_version_channel_uk
    (aggregate_type, aggregate_id, aggregate_version, channel, projection),
  KEY outbox_claim_idx (status, available_at, id),
  KEY outbox_lock_timeout_idx (status, locked_at)
) ENGINE=InnoDB COMMENT='状态变化的事务发布命令与 Relay 租约状态';
状态更新和通知命令在同一个 InnoDB 事务中提交:
START TRANSACTION;

SELECT workflow_id, version
FROM task
WHERE id = :task_id
FOR UPDATE;

SELECT version, source_seq, operation_code, execution_id
FROM task_step
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
FOR UPDATE;

UPDATE task_step
SET lifecycle_status = :step_lifecycle_status,
    business_status = :business_status,
    health = :step_health,
    data_schema = :data_schema,
    state_data = CAST(:state_data_json AS JSON),
    error_category = :error_category,
    error_code = :error_code,
    error_message = :error_message,
    error_retryable = :error_retryable,
    diagnostics_ref = :diagnostics_ref,
    source_seq = :source_seq,
    version = :new_step_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
  AND source_seq < :source_seq;

UPDATE task
SET lifecycle_status = :lifecycle_status,
    business_status = :business_status,
    health = :task_health,
    summary_schema = :summary_schema,
    summary_data = CAST(:summary_data_json AS JSON),
    failure_code = :failure_code,
    failure_message = :failure_message,
    failed_step_id = :failed_step_id,
    version = :new_version,
    updated_at = UTC_TIMESTAMP(3)
WHERE id = :task_id
  AND attempt = :task_attempt;

INSERT INTO task_outbox (
  aggregate_type,
  aggregate_id,
  aggregate_version,
  channel,
  projection,
  payload
) VALUES (
  'TASK',
  :task_id,
  :new_version,
  :channel,
  :projection,
  CAST(:complete_state_json AS JSON)
);

INSERT INTO task_event_log (
  event_id,
  workflow_id,
  task_id,
  task_version,
  step_id,
  operation_code,
  execution_id,
  step_version,
  task_attempt,
  step_attempt,
  producer_id,
  source_seq,
  event_type,
  lifecycle_status,
  business_status,
  health,
  data_schema,
  error_code,
  occurred_at,
  received_at,
  committed_at,
  duration_ms,
  payload
) VALUES (
  :event_id,
  :workflow_id,
  :task_id,
  :new_version,
  :step_id,
  :operation_code,
  :execution_id,
  :new_step_version,
  :task_attempt,
  :step_attempt,
  :producer_id,
  :source_seq,
  :event_type,
  :lifecycle_status,
  :business_status,
  :health,
  :data_schema,
  :error_code,
  :occurred_at,
  :received_at,
  UTC_TIMESTAMP(3),
  :duration_ms,
  CAST(:event_payload_json AS JSON)
);

INSERT INTO task_event_dedup (
  event_id,
  task_id,
  payload_hash,
  result
) VALUES (
  :event_id,
  :task_id,
  :payload_hash,
  CAST(:result_json AS JSON)
);

COMMIT;
实际实现应先 SELECT ... FOR UPDATE 锁定任务并读取当前版本,再完成状态机校验和更新;不要依赖上面简化 SQL 猜测 :new_version。
同一已接受事件可以在事务内生成多条不同频道的 Outbox 记录:用户频道写 USER_SUMMARY 投影,任务频道写 TASK_DETAIL 投影。投影器从已校验的当前状态构建载荷,不能把 Worker 原始 JSON 原样转发;否则来源服务可能绕过字段裁剪,把只允许出现在详情中的数据泄漏到摘要或广播频道。
5.2 心跳写入与超时扫描
普通心跳走轻量更新路径,只推进当前 execution 的心跳序号和服务端接收时间:
UPDATE task_step
SET last_heartbeat_seq = :heartbeat_seq,
    last_heartbeat_at = UTC_TIMESTAMP(3)
WHERE task_id = :task_id
  AND step_id = :step_id
  AND attempt = :step_attempt
  AND execution_id = :execution_id
  AND lifecycle_status = 'RUNNING'
  AND health = 'HEALTHY'
  AND last_heartbeat_seq < :heartbeat_seq;
更新行为影响 0 行时,应用不能一律返回成功:它需要区分重复序号、旧 attempt、错误 execution、已经终止和当前为 STALE。重复心跳可以幂等返回;其他情况必须返回明确原因。STALE execution 恢复心跳时要走完整状态事务,产生 STEP_HEALTH_CHANGED 和新版本,不能用上面的轻量 SQL 静默改回 HEALTHY。
Health Reconciler 多副本可以分批领取疑似超时行:
START TRANSACTION;

SELECT task_id, step_id, attempt, execution_id,
       last_heartbeat_seq, last_heartbeat_at,
       heartbeat_timeout_seconds
FROM task_step
WHERE lifecycle_status = 'RUNNING'
  AND health = 'HEALTHY'
  AND heartbeat_timeout_seconds IS NOT NULL
  AND TIMESTAMPADD(
        SECOND,
        heartbeat_timeout_seconds,
        last_heartbeat_at
      ) <= UTC_TIMESTAMP(3)
ORDER BY last_heartbeat_at
LIMIT 100
FOR UPDATE SKIP LOCKED;

-- 对每行再次检查 attempt / executionId / heartbeatSeq 后,
-- 通过统一状态事务写 health=STALE、事件日志与 Outbox。

COMMIT;
扫描索引只能先缩小 RUNNING + HEALTHY 候选范围;每行超时时间不同,仍需结合实际数据量评估执行计划。大规模场景可以在步骤表维护单独的 heartbeat_deadline_at 并建立索引,或使用分片时间轮调度检测,但 MySQL 中的 last_heartbeat_at 仍应保留为恢复和审计依据。
5.3 多副本 Relay 如何安全领取
多个 Relay 可以使用 MySQL 8.0 的 FOR UPDATE SKIP LOCKED 并发领取不同记录。MySQL 官方明确指出,SKIP LOCKED 会跳过已经被其他事务锁定的行,适合多个会话访问同一队列表;它不适合需要一致性视图的普通业务查询。参见 InnoDB Locking Reads。
START TRANSACTION;

SELECT id
FROM task_outbox
WHERE status = 'PENDING'
  AND available_at <= UTC_TIMESTAMP(3)
ORDER BY id
LIMIT 100
FOR UPDATE SKIP LOCKED;

UPDATE task_outbox
SET status = 'PROCESSING',
    locked_by = :relay_id,
    locked_at = UTC_TIMESTAMP(3),
    attempts = attempts + 1
WHERE id IN (:claimed_ids);

COMMIT;
Relay 在事务外调用 Centrifugo Server API,成功后将记录更新为 PUBLISHED。失败时按指数退避计算新的 available_at,回到 PENDING。如果 Relay 在“发布成功、标记完成之前”崩溃,记录会在锁租约过期后重试,因此客户端必须允许重复消息。
每条消息必须携带完整状态和 aggregate_version。这样即使多个 Relay 导致同一任务的通知晚到或乱序,客户端仍会忽略旧版本,正确性不依赖严格的全局发布顺序。
如果 Worker 已完成业务,却在状态上报前崩溃,状态服务的 Outbox 无法凭空知道这次完成。来源服务仍需要持久化重试、本地 Outbox,或由对账任务查询实际结果并修复状态。
六、通知设计:可选传输、有限订阅与受控广播
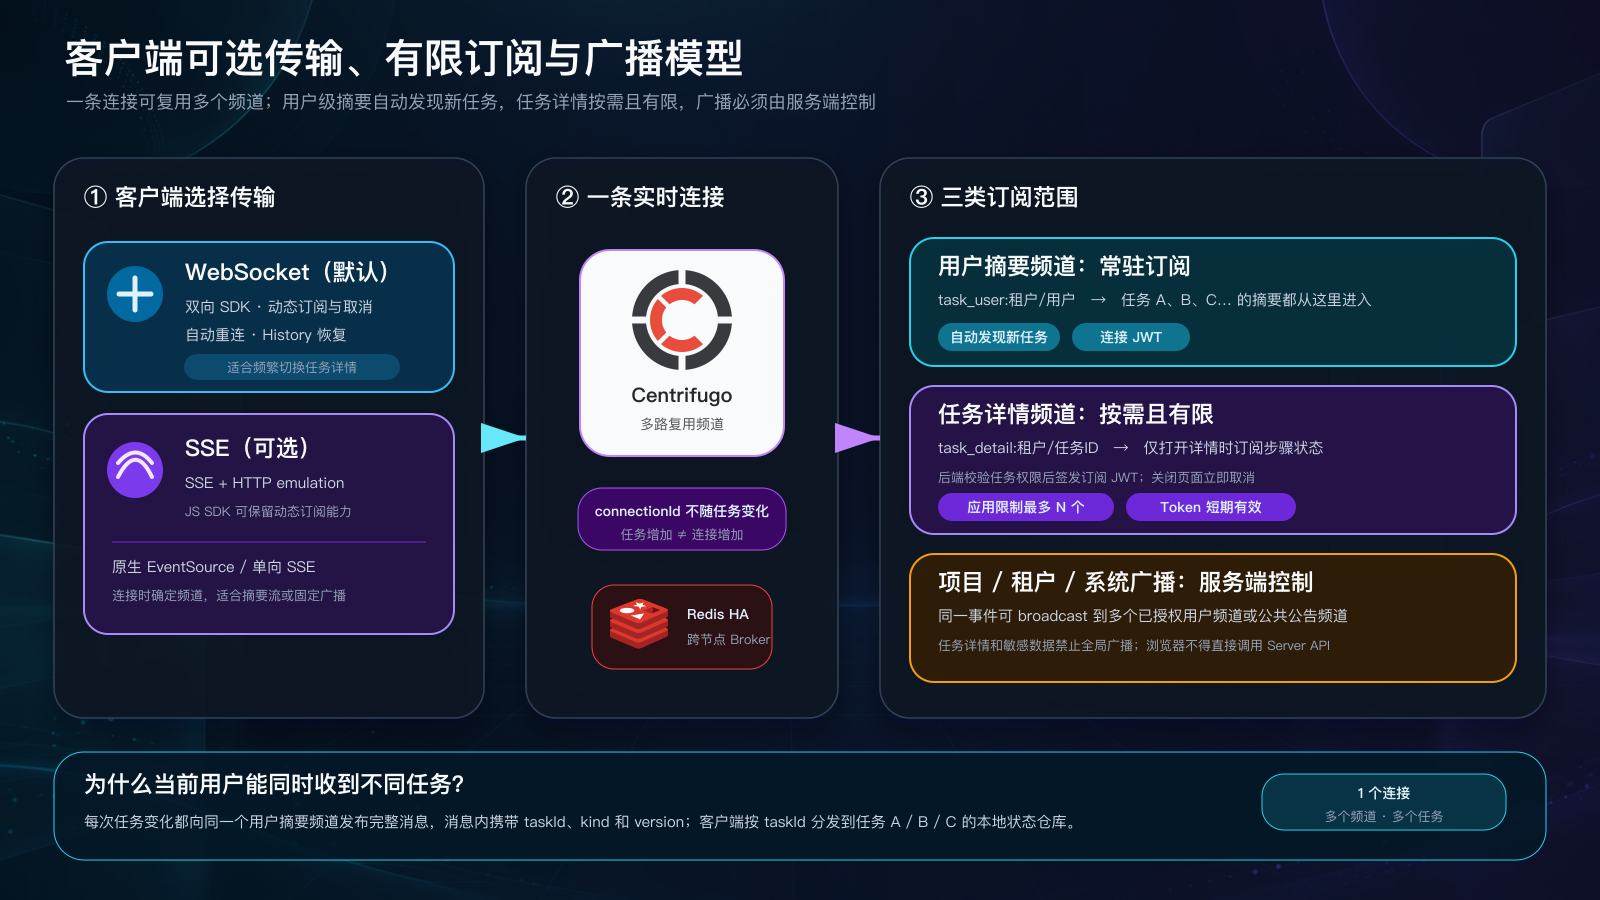
订阅模型图:一条物理连接可以复用多个逻辑频道;用户摘要常驻,任务详情按需且有限,项目、租户与系统广播只能由服务端授权和发布。
6.1 一个 workflow 下多个 taskId 如何隔离并通知
先区分四个基数:
一个 workflow  → 一个稳定 workflowId + 一个或多个独立 taskId
一个任务        → 一个 canonical taskId + 一条独立 taskVersion 序列
一个用户        → 可以关联多个 workflowId 和多个 taskId
一个客户端会话  → 一条 WS 或 SSE 物理连接
一条物理连接    → 一个用户摘要订阅 + 可选 workflow 摘要 + 有限个任务详情订阅
不要给“同一个任务当前状态”分配多个并列 taskId,也不要让多个独立任务共享顶层 workflow 的版本。不同场景应这样建模:
| 业务关系 | 推荐标识方式 |
|---|---|
| 一次业务流程包含多个独立任务 | 一个 workflowId + 多个独立 taskId |
| 一个任务包含多个处理步骤 | 一个 taskId + 多个 stepId/executionId |
| 一次纯批处理只需分组、不需要整体状态 | 一个 batchId 关联多个 taskId 或多个 workflow |
| 父任务派生独立子任务 | 每个任务自己的 taskId,子任务记录 parentTaskId |
| 外部系统已有不同业务编号 | 保留一个 canonical taskId,使用 externalRef 映射外部编号 |
| 一个用户拥有或被授权查看多个任务 | ownerId/task_acl 将用户关联到多个 taskId |
例如一次材料处理流程可以表示为:
workflowId = wf-material-001       workflowVersion=8
  ├─ task-a  合同解析             taskVersion=12
  ├─ task-b  发票识别             taskVersion=3
  └─ task-c  报表导出             taskVersion=27
三个任务拥有各自独立的 taskVersion、状态机、失败策略、终态、数据 Schema 和详情权限,但都会携带同一个 workflowId 并进入有权用户的摘要频道。workflowVersion=8 只表示顶层成员或聚合视图的第八个版本,不能与任何 taskVersion 比较。batchId 仍可用于跨 workflow 的运营分组,但不能代替 workflowId 或单任务 taskId。
登录期间始终订阅:
task_user:{tenantId}/{userId}
它发送用户有权看到的任务摘要:
{
  "kind": "task.summary",
  "schemaVersion": 1,
  "workflowId": "wf-material-001",
  "workflowVersion": "8",
  "task": {
    "id": "task-a",
    "productId": null,
    "taskType": null,
    "title": "处理用户上传的材料",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "WAITING_REVIEW",
    "health": "HEALTHY",
    "version": "12",
    "startedAt": "2026-09-21T07:10:00Z",
    "finishedAt": null,
    "elapsedMs": 18000,
    "asOf": "2026-09-21T07:10:18Z",
    "summaryData": {
      "schema": "document.process.summary.v1",
      "value": {"fileName": "contract.pdf", "pageCount": 36}
    }
  }
}
productId/taskType 为空时,客户端仍然依靠公共信封展示标题、生命周期、健康和耗时,并使用通用任务卡;分类事件到达后再切换到产品专用渲染器,不能因为没有产品标识就隐藏任务。
workflow 下新增 task-b、task-c,或者另一个 workflow 新增 task-d,都归入同一用户频道,所以不需要重建连接,也不需要提前知道未来的任务 ID。
这里的“同一用户频道”表示同一租户下经过服务端权限计算的个人投影。任务可以因为 ownerId=user-1、显式 task_acl 或项目成员关系被投影给该用户;workflowId 只说明业务归组,不是访问凭证,productId 是否为空也不影响授权关系。
默认隔离规则如下:
| 场景 | 用户能收到什么 |
|---|---|
| 用户 A 创建 workflow,未共享 | 只有 A 收到 workflow 与其任务摘要,用户 B 即使知道 ID 也不能订阅 |
| workflow 授权给用户 B,且任务继承授权 | A、B 各自在自己的用户频道收到同一个 task 的相同权威版本 |
| workflow 已共享,但 task-c 被标记为敏感 | B 只能看到有权任务;workflow 汇总必须按 B 的可见范围裁剪,不能泄露 task-c |
两个用户分别创建相同 taskType | 任务由不同 taskId 和 ACL 隔离,不会因为类型相同进入对方频道 |
这也是“当前用户如何同时收到不同任务数据”的关键:不是给每个任务各建一条 WebSocket,而是所有任务摘要都发布到当前用户唯一的摘要频道。消息带上 taskId、kind 与 version,客户端再路由到不同本地对象:
function onPublication(message: TaskSummaryMessage) {
  const taskKey = `${message.workflowId}:${message.task.id}`;
  const current = taskStore.get(taskKey);
  if (!current || BigInt(message.task.version) > BigInt(current.version)) {
    taskStore.set(taskKey, message.task);
  }
}
如果 taskId 全局唯一,技术上只用 taskId 作为 Map Key 也安全;显式保留 workflowId:taskId 更利于前端分组、日志排查和防止错误数据被渲染到另一个 workflow。服务端仍必须以数据库中的 task→workflow 关系为准,不能相信客户端随消息或订阅参数提交的 workflowId。
无论任务 A、B、C 谁先变化,都进入同一个连接;任务 D 刚刚创建,也会自动出现在频道中。Centrifugo 的服务器侧订阅正适合这种用户个人频道,且官方建议用个人频道承载用户更新,避免为大量对象逐个创建订阅。参见 Server-side subscriptions 与 FAQ: scalability considerations。
摘要频道内不同任务的消息可以交错到达,不提供跨任务全局顺序:
wf-material-001 / task-a / taskVersion=12
wf-material-001 / task-c / taskVersion=27
wf-material-001 / task-b / taskVersion=3
wf-material-001 / task-a / taskVersion=13
wf-material-001 / workflowVersion=9
这是合法顺序。客户端只在同一个 taskId 内比较 taskVersion,只在同一个 workflowId 内比较 workflowVersion;不能拿 task-a 的 13 与 task-b 的 3 比较,也不能拿 workflow 的 9 与 task 的 13 比较。
6.1.1 task 通知与 workflow 聚合通知是两条独立事实流
task 状态提交不能等待所有兄弟任务,也不需要锁 workflow 下的全部 task。一次 task-a 更新只锁 task-a,提交 task-a 的事件、taskVersion 和 Outbox;task-b 可以在另一副本甚至另一分片并发提交。可选的 Workflow Projector 再根据这些已提交事实更新顶层聚合视图:
因此用户可能先看到 task-b 失败,再看到 workflow 总体变成 DEGRADED,这是正常的最终收敛过程。前端遵守以下规则就不会串状态:
task.summary      去重键 = taskId + taskVersion
task.detail       去重键 = taskId + taskVersion(步骤另看 stepVersion)
workflow.summary  去重键 = workflowId + workflowVersion
用户提醒          去重键 = userId + taskId + taskVersion + notificationType
workflow 摘要可以直接进入常驻用户频道;只有当某个页面需要持续观察一个 workflow、且其中任务很多时,才额外订阅 workflow_summary:{tenantId}/{workflowId}。这个频道只发送整体状态与经过 ACL 裁剪的任务摘要,不发送所有任务的步骤详情。用户打开具体任务后,仍按需订阅 task_detail:{tenantId}/{taskId}。
6.2 任务详情频道
用户打开详情时按需订阅:
task_detail:{tenantId}/{taskId}
关闭详情时只取消这个订阅,应用级连接仍保留。详情消息携带任务本身和步骤的完整当前状态:
{
  "kind": "task.detail",
  "schemaVersion": 1,
  "workflowId": "wf-material-001",
  "taskId": "8a4d",
  "version": "12",
  "taskType": "DOCUMENT_PROCESS",
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSING",
  "steps": [
    {
      "id": "01_prepare",
      "operationCode": "FILE.PREPARE",
      "lifecycleStatus": "SUCCEEDED",
      "businessStatus": "PREPARED",
      "durationMs": 3000
    },
    {
      "id": "02_parse",
      "operationCode": "DOCUMENT.PARSE",
      "lifecycleStatus": "RUNNING",
      "businessStatus": "PARSING",
      "startedAt": "2026-09-21T07:10:03Z",
      "data": {
        "schema": "document.parse.progress.v1",
        "value": {"currentPage": 18, "totalPages": 36}
      }
    },
    {
      "id": "03_store",
      "operationCode": "RESULT.PERSIST",
      "lifecycleStatus": "PENDING",
      "businessStatus": "QUEUED"
    }
  ]
}
6.3 为什么分两级
| 只用用户频道 | 只用任务频道 | 两级订阅 |
|---|---|---|
| 容易发现新任务,但所有步骤详情会广播过多 | 详情精确,但新任务需要不断新增订阅 | 列表自动发现,详情按需加载 |
用户有一万个历史任务时,摘要频道仍应只推发生变化的当前摘要;列表快照使用分页。详情频道只服务正在查看该任务的客户端。
6.4 客户端可选 WebSocket 或 SSE
传输方式不改变频道模型、鉴权或版本规则,只改变连接如何承载消息:
| 模式 | 能力 | 适用场景 | 限制 |
|---|---|---|---|
| WebSocket | 双向、动态订阅/取消、自动重连与 History 恢复 | Web、桌面和原生 App 的默认选择 | 某些企业代理可能限制升级连接 |
| SSE + HTTP emulation | 下行使用 SSE,上行命令使用 HTTP;JS SDK 仍可动态订阅 | WebSocket 不可用时的浏览器回退 | 请求数和代理配置比 WebSocket 更复杂 |
| 原生单向 SSE / EventSource | 简单的服务器到客户端事件流 | 固定用户摘要、只读大屏、轻量广播 | 连接建立后不适合频繁动态增减详情订阅 |
三种方式都能让一个用户摘要流承载多个 workflowId 以及每个 workflow 下的多个 taskId。区别只在详情订阅怎样变化:WebSocket 在原连接内发送订阅命令;SSE emulation 通过 HTTP 控制面增减逻辑订阅;原生 EventSource 通常在建立连接时由服务端固定用户频道和有限详情集合,改变集合需要更新服务端 watch set 或重新连接。
在浏览器中,可以让 SDK 按顺序尝试 WebSocket 与双向 SSE emulation:
import { Centrifuge } from 'centrifuge';

const realtime = new Centrifuge(
  [
    {
      transport: 'websocket',
      endpoint: 'wss://realtime.example.com/connection/websocket',
    },
    {
      transport: 'sse',
      endpoint: 'https://realtime.example.com/connection/sse',
    },
  ],
  {
    token: connectionToken,
    getToken: refreshConnectionToken,
  },
);
双向 SSE emulation 不是“只有下行的 EventSource”:SDK 通过 SSE 接收,通过 HTTP emulation 发送订阅等命令,因此仍能保留动态频道能力。原生单向 SSE 则适合连接时已经确定好的服务器侧订阅;如果页面需要频繁切换任务详情,优先使用 WebSocket 或双向 SSE emulation。参见 Transport overview、SSE bidirectional emulation 与 Unidirectional SSE。
6.5 任务详情订阅必须有限
“按需订阅”不等于“可以无限订阅”。推荐把限制分成三层:
- UI 只订阅当前打开、可见或固定关注的任务,页面离开后立即取消;
- 业务后端签发订阅 JWT 前检查任务 ACL、会话和应用级配额;
- 高风险场景启用订阅代理或由后端调用 Server API 动态订阅,把最终授权留在服务端。
例如产品可以配置 maxDetailSubscriptionsPerConnection = 20,这是应用策略,不是协议常量。超过上限时,客户端应先按 LRU 取消最早不可见的详情频道,再申请新频道;后端返回明确的 DETAIL_SUBSCRIPTION_LIMIT,不能静默放宽权限。
常驻:task_user:t1/u1                         1 个
按需:workflow_summary:t1/wf-material-001     可选,只有 workflow 页面需要
按需:task_detail:t1/task-a ... task-t       最多 20 个
总览:其余任务仍通过用户摘要频道持续收到变化
仅在客户端计数属于体验优化,不是安全边界。强制限制需要服务端维护连接或会话的订阅租约,并在签发 token、订阅代理或动态订阅时原子检查;短期订阅 JWT 还应绑定 sub + channel + exp。Centrifugo 的频道权限模式可参考 Channel permissions。
6.6 广播支持:广播范围越大,载荷越小
系统可以支持广播,但必须先定义范围:
| 范围 | 频道示例 | 可以发送 | 不应该发送 |
|---|---|---|---|
| 当前用户 | task_user:t1/u1 | 该用户任务摘要 | 其他用户数据 |
| 项目成员 | task_project:t1/p9 | 项目级任务概览 | 无权限成员的结果、密钥、完整错误栈 |
| 租户 | task_tenant:t1 | 维护提示、租户级批处理进度 | 单个用户的敏感任务详情 |
| 系统公共 | task_system:public | 版本通知、公开维护状态 | 任何业务任务数据 |
同一个事件需要到达多个已授权频道时,Outbox Relay 可以调用 Centrifugo broadcast Server API;第一版也可以展开成多条 publish Outbox 记录,换取更简单的逐频道重试与审计。大规模广播应分批异步执行,避免一次命令过大阻塞普通任务通知。官方 Server API 支持对一组频道广播相同数据,见 Server API broadcast。
{
  "method": "broadcast",
  "channels": [
    "task_user:t1/u1",
    "task_project:t1/p9"
  ],
  "data": {
    "kind": "task.summary",
    "workflowId": "wf-material-001",
    "taskId": "8a4d",
    "version": "12",
    "lifecycleStatus": "RUNNING",
    "businessStatus": "WAITING_REVIEW"
  }
}
浏览器不能直接调用 Server API,也不能自己决定广播目标。业务服务先计算接收范围,事务内写入可审计的 Outbox 命令,Relay 才能执行发布。
6.7 一条连接为何能承载多个任务
Centrifugo 在一条传输连接上复用多个逻辑频道。连接身份保持不变,任务集合通过两条路径变化:
新任务出现
  → 用户摘要频道自动收到 task.summary
  → 不需要新增连接或订阅

用户打开某个任务
  → 申请该 task_detail 的短期订阅授权
  → 在现有连接上增加逻辑订阅
  → 关闭页面时取消,不影响其他任务
因此连接数大致随在线用户数增长,而不是随“在线用户数 × 历史任务数”增长;活跃详情订阅数则由页面行为和应用配额独立控制。
当前设计的支持范围可以归纳为:
| 需求 | 是否支持 | 实现方式 |
|---|---|---|
| 一个 workflow 包含多个独立任务 | 支持,核心模型 | workflowId 建立成员关系,每个 taskId 保持自己的版本和终态 |
| 一个用户接收多个 workflow | 支持,默认能力 | 所有有权 workflow/task 摘要进入一个用户频道 |
| 一个用户接收多个任务摘要 | 支持,默认能力 | 常驻一个 task_user:{tenantId}/{userId} 逻辑订阅 |
| 多个任务共用一条 WebSocket | 支持 | 同一物理连接复用摘要频道和多个详情频道 |
| 多个任务共用一条 SSE | 支持 | SSE emulation 复用逻辑订阅;原生 SSE 使用固定用户流 |
| 新任务创建后自动出现 | 支持 | 新任务摘要直接发布到用户频道,无需客户端预知 taskId |
| 同时查看多个任务详情 | 支持但有限额 | 在同一连接增加多个 task_detail 订阅,例如最多 20 个 |
| 一个摘要订阅接收全部任务完整步骤 | 默认不支持,也不建议 | 数据量和敏感信息过大,应按需订阅详情 |
| 一个 taskId 代表多个独立任务 | 不支持 | 使用一个 workflowId 关联多个 canonical taskId |
| 不同用户因为知道 workflowId/taskId 就能订阅 | 不支持 | 服务端按 workflow/task ACL 计算频道和消息接收者 |
需要注意,“一个用户一条连接”是按客户端会话计算,不是整个账号全球只能存在一条连接。同一用户可以同时登录 Web、手机和桌面端,每个会话各有一条连接并订阅同一个用户频道;所有设备都会收到任务摘要,已读状态是否同步则由独立通知中心决定。
6.7.1 是否需要一次消息携带多个 taskId
实时变化通常推荐“一条 publication 更新一个 taskId”,因为每个任务有独立版本、权限和重试边界:
{
  "kind": "task.summary",
  "workflowId": "wf-material-001",
  "taskId": "task-a",
  "taskVersion": 13,
  "state": {"lifecycleStatus": "RUNNING", "progress": 62}
}
一条连接会连续收到同一或不同 workflow 的 task-a、task-b、task-c publication,这已经实现“多个 taskId 从同一 WS/SSE 下发”,不需要把它们强行装进同一个 JSON。初始化、断线恢复失败或批量校准时可以返回数组,但数组中每个元素仍必须携带自己的 workflowId + taskId + taskVersion:
{
  "kind": "task.summary.batch",
  "items": [
    {"workflowId": "wf-1", "taskId": "task-a", "taskVersion": 13, "state": {}},
    {"workflowId": "wf-1", "taskId": "task-b", "taskVersion": 3, "state": {}},
    {"workflowId": "wf-2", "taskId": "task-c", "taskVersion": 27, "state": {}}
  ]
}
批量消息只是传输优化,不能共享一个总版本。任意一项过旧时客户端只忽略那一项,不能丢弃整个批次。
6.7.2 原生 SSE 如何支持用户摘要和有限详情
若使用简单的浏览器 EventSource,可以提供固定用户流:
GET /api/v1/me/task-stream
Accept: text/event-stream
Last-Event-ID: user-feed-cursor
服务端从登录身份确定用户,自动接入用户摘要频道。事件始终包含 taskId,因此一个 EventSource 足以更新任务列表。需要查看详情时,优先通过普通 HTTP 拉取详情快照;如果确实需要多个任务持续详情,可创建有数量限制的 watch set:
PUT /api/v1/me/task-watch-set
Content-Type: application/json

{"taskIds": ["task-a", "task-b"]}
服务端逐个验证 ACL 后,把这些详情流合并到当前会话的 SSE;删除或增加 taskId 时更新 watch set。watch set 必须绑定 userId + sessionId、设置数量上限和过期时间,不能让客户端仅凭知道 taskId 就订阅。
6.8 异常时如何让用户真正收到任务状态
异常状态不能只写进步骤表,更不能只发到“用户可能没有订阅”的详情频道。每次已确认异常至少生成两个投影:
task_user:{tenantId}/{userId}收到带异常摘要的完整task.summary,保证用户只订阅一个常驻频道也能发现失败;task_detail:{tenantId}/{taskId}收到步骤、功能数据和脱敏错误详情,供已经打开详情的页面展示。
用户摘要消息仍然是完整任务当前值,只额外包含一个可选 notice。这样客户端收到通知时可以同时更新列表、显示 Toast,并按 taskId + version 去重:
{
  "kind": "task.summary",
  "schemaVersion": 1,
  "task": {
    "id": "task-8a4d",
    "taskType": "DOCUMENT_PROCESS",
    "lifecycleStatus": "FAILED",
    "businessStatus": "PARSE_FAILED",
    "health": "HEALTHY",
    "version": "13",
    "failedStepId": "02_parse"
  },
  "notice": {
    "id": "task-8a4d:13",
    "type": "TASK_FAILED",
    "level": "ERROR",
    "title": "合同解析失败",
    "message": "暂不支持该文件格式,请转换为 PDF 后重试",
    "operationCode": "DOCUMENT.PARSE",
    "errorCode": "UNSUPPORTED_FILE_FORMAT",
    "retryable": false,
    "requiresAction": true,
    "actions": ["REUPLOAD_FILE", "VIEW_DETAILS"]
  }
}
通知策略要由最终状态和异常类型驱动:
| 已确认事实 | 用户摘要频道 | 任务详情频道 | 可选离线通知 |
|---|---|---|---|
STEP_FAILED,准备自动重试 | WARNING:“步骤失败,正在重试” | 完整失败 attempt 和下一轮信息 | 通常不发 |
| 可选步骤失败、任务继续 | WARNING,任务标记 DEGRADED | 错误详情与受影响功能 | 仅业务要求时发送 |
TASK_FAILED | ERROR,必须发布且不能被进度合并吞掉 | 最终错误、失败步骤和可执行操作 | 可按用户偏好发送站内信、Push 或邮件 |
health=STALE | WARNING:“状态暂时无法确认” | 最近心跳和检测时间 | 通常不发,持续超阈值再升级 |
| 实时连接中断 | 本地显示 RECOVERING/STALE | 重连后 History 或快照恢复 | 不能把连接故障通知成任务失败 |
中间 STEP_PROGRESS 可以按短窗口合并,但 STEP_FAILED、TASK_FAILED、CANCELLED、SUCCEEDED 和 requiresAction=true 的消息必须绕过普通进度合并。若 Relay 多次重试后进入 DEAD,这是运维告警,不是业务失败;客户端最终仍通过 MySQL 快照获得真实终态。
WebSocket/SSE 只覆盖在线连接。产品如果要求“用户离线也必须知道任务失败”,应把终态或需人工处理的事件同时写入独立、持久化的通知命令,由 Notification Service 生成站内未读记录并按用户偏好发送 Push/邮件。其幂等键可使用 userId + taskId + taskVersion + notificationType,避免 Relay 重试导致重复提醒。
七、认证与授权:频道名不是权限
7.1 连接 JWT
前端先用已有登录会话请求实时连接信息:
GET /api/realtime/session
后端从已验证身份中读取租户和用户,签发短期连接 JWT:
{
  "sub": "t1/u1",
  "channels": ["task_user:t1/u1"],
  "aud": "task-realtime",
  "iss": "task-status-service",
  "exp": 1789981200
}
channels 会在连接建立时创建服务器侧订阅。官方特别说明,这个 claim 表示“自动订阅”,不是一张任意频道权限清单。参见 Client JWT authentication。
7.2 订阅 JWT
打开任务详情时,前端向业务后端请求:
POST /api/realtime/subscription-token
Content-Type: application/json

{"taskId":"8a4d"}
后端必须重新执行任务权限检查:
验证登录身份
  → 查询任务 tenantId / ownerId / project ACL
  → 构造服务端认可的准确频道
  → 签发 channel + sub + exp
{
  "sub": "t1/u1",
  "channel": "task_detail:t1/8a4d",
  "exp": 1789981200
}
订阅 JWT 的 sub 必须与连接用户一致,channel 必须是后端完成授权后构造的值。参见 Channel JWT authorization。
下面这些做法都不安全:
- 相信浏览器提交的
tenantId、userId或完整频道名; - 把其他用户数据推到前端,再依赖 UI 隐藏;
- 把 JWT 签名密钥或 Centrifugo Server API Key 发给浏览器;
- 为解决 403,直接允许所有登录用户订阅任意任务频道。
八、客户端合并:快照和推送一定会乱序
8.1 每个对象只接受更高版本
type Versioned = {
  id: string;
  version: bigint;
};

function shouldApply(local: Versioned | undefined, incoming: Versioned) {
  return !local || incoming.version > local.version;
}
版本建议以十进制字符串通过 JSON 传输,再在支持的客户端转换成 64 位整数或 bigint,避免 JavaScript number 的安全整数上限问题。
8.2 摘要与详情分别维护版本门
summaryVersion[taskId] = 12
detailVersion[taskId]  = 10
收到 task.summary version=12,不能认为 task.detail version=12 已经处理,因为摘要并不包含步骤集合。摘要和详情要分别缓存、分别合并。
8.3 初始化采用“先订阅、后快照”
如果先查快照、再建立订阅,状态可能恰好在两者之间改变并被漏掉。订阅后缓冲、再加载快照、最后按版本重放,才能关闭这个竞态窗口。
8.4 重连采用两级恢复
Centrifugo 的双向 SDK 会保存频道 epoch/offset,在重订阅时尝试补齐短暂断线期间的消息;只有当历史连续可用时才返回恢复成功,否则应用应加载业务快照。官方恢复流程见 Stream history and recovery。
对任务状态这种“当前值”系统,发布完整对象而不是差量补丁更容易恢复。即使漏掉:
PENDING → RUNNING → SUCCEEDED
只要最终收到更高版本的完整 SUCCEEDED 状态,客户端就能收敛;如果业务需要每个中间事件都可审计,应额外建设不可变事件表,而不是依赖实时频道历史。
8.5 状态合并和用户提醒要使用不同的去重门
任务状态按 taskId + version 合并;Toast、声音或系统通知则按 notice.id 去重。二者不能共用一个布尔值:页面可能已经通过快照得到 version=13,随后又收到同版本实时消息,此时不应回退状态,也不应重复弹出已读提醒。
function handleSummary(message: TaskSummaryMessage) {
  mergeTaskWhenVersionIsNewer(message.task);

  if (message.notice && !noticeStore.hasSeen(message.notice.id)) {
    showNotice(message.notice);
    noticeStore.markSeen(message.notice.id);
  }
}
若“未读”需要跨设备同步,就把已读状态保存到持久化通知中心;浏览器本地集合只能防止单页面重复弹窗。重新加载历史快照时默认更新任务卡片,不重新弹出旧终态;只有持久化通知中心仍标记为未读时才展示未读入口。
九、耗时:后端确认,前端平滑显示
9.1 运行中不需要每秒推送
后端在步骤开始时发送:
{
  "lifecycleStatus": "RUNNING",
  "businessStatus": "PARSING",
  "elapsedMs": 37000,
  "asOf": "2026-09-21T07:10:37Z"
}
前端记录收到消息时的单调时钟:
const receivedAt = performance.now();
const baseElapsedMs = task.elapsedMs;

function displayedElapsedMs() {
  return baseElapsedMs + performance.now() - receivedAt;
}
页面使用一个共享定时器刷新可见行即可。这不会产生网络请求、推送或数据库写入。
9.2 终态使用后端最终值
{
  "lifecycleStatus": "SUCCEEDED",
  "businessStatus": "COMPLETED",
  "durationMs": 42000
}
收到终态后停止本地累加。浏览器从休眠或后台恢复、页面重新获得可见性、系统网络切换后,应重新获取当前状态校准。
9.3 明确耗时口径
| 指标 | 推荐定义 |
|---|---|
| 排队耗时 | startedAt - createdAt |
| 当前尝试耗时 | 当前 attempt 的开始到结束 |
| 任务总耗时 | 任务正式开始到权威终态的墙钟时间 |
| Worker 执行耗时 | Worker 使用单调时钟测量并在终态上报 |
| 并行步骤耗时 | 分别展示,不能直接相加为用户等待时间 |
跨机器时间戳适合表达时间线,但不适合在时钟未可靠同步时精确计算 Worker 内部耗时。精确执行时长应由同一进程的单调时钟测量。
十、通知可靠性:不要说“消息绝不丢”
这条链路包含不同层次的保证:
| 链路 | 目标语义 | 处理方式 |
|---|---|---|
| Worker → 状态服务 | 幂等重试 | eventId + payloadHash |
| 状态服务 → MySQL | 原子提交 | 当前状态、不可变事件、版本、去重结果、Outbox 同一个 InnoDB 事务 |
| MySQL Outbox → Relay | 多副本竞争领取 | SKIP LOCKED、锁租约、失败退避 |
| Relay → Centrifugo | 至少一次 | 发布失败重试,崩溃窗口允许重复 |
| Centrifugo → 在线客户端 | 实时分发 + 有界恢复 | history、positioning、SDK recovery |
| 客户端 → 最终视图 | 最终收敛 | 完整对象、version 去重、快照兜底 |
Relay 必须自己区分可重试错误和永久错误:网络超时、429、5xx 进入带抖动的指数退避;无效频道或无法序列化的消息进入 DEAD 并告警,不能无限热循环。不能因为使用了 Outbox 就宣称整条链路“绝不丢”;官方也建议应用处理异步发布中的重复与晚到消息,详见 async consumers。
真正可对外承诺的语义应该是:
状态服务成功响应,表示状态已持久化;实时通知可能重复、乱序或短暂中断,但客户端会通过版本和权威快照重新收敛。
十一、高可用:逐层消除单点
11.1 生产拓扑
11.2 Task Status Service
状态服务保持无状态并运行至少两个副本:
- 登录身份和服务身份从可验证 Token 或 mTLS 获取;
- 不把幂等结果、任务锁、订阅权限只保存在单机内存;
- 每个请求有 deadline,数据库连接池有上限;
- 就绪检查必须验证进程是否能够服务,但不要把瞬时下游抖动放大成全部 Pod 同时摘除;
- 发布版本时先停止接收新流量,再等待在途事务完成。
并发更新同一个任务时,用任务行锁、乐观版本或按 taskId 分区的有序处理保证单任务串行;不要使用覆盖整个平台的全局锁。
11.3 MySQL
MySQL 保存唯一权威状态,因此它的 RPO/RTO 比实时网关更重要:
- 使用 InnoDB、托管 Multi-AZ,或经过演练的 Group Replication / InnoDB Cluster;
- 自动备份与时间点恢复不能省略;
- 应用通过稳定 writer endpoint 连接,而不是写死节点 IP;
- 故障切换期间,写入可以短暂失败,调用方按同一个
eventId重试; - 定期做恢复演练,证明备份真的能还原,而不是只证明“备份任务显示成功”。
Outbox 与业务表在同一个数据库事务中,数据库切换后它们一起保留或一起回滚,不会出现跨两个存储提交一半的状态。
如果自建高可用,MySQL 官方说明 Group Replication 可以运行在 single-primary 模式并自动选举新主,但客户端仍需要 MySQL Router、代理或连接器切换到新节点;它本身不替应用完成连接故障转移。参见 Group Replication。时间点恢复则依赖完整备份后的 binary log,参见 Point-in-Time Recovery。
11.4 Outbox Relay
Relay 至少运行两个副本,并把正确性放在 MySQL 中,而不是本机内存:
- 使用
FOR UPDATE SKIP LOCKED领取互不重叠的批次; locked_at是租约而不是永久所有权,超时记录可被其他副本接管;- 发布 API 使用短 deadline,失败后释放记录并延迟重试;
- 单条永久错误进入死信状态,不阻塞后续记录;
- 滚动发布时停止领取新批次,处理完已领取记录再退出;
- 定期清理已发布记录,但保留足够窗口用于排障和审计。
Relay 不需要强制全局有序,因为消息包含完整状态与单调版本。若某个下游真的要求严格的单任务事件顺序,则需要再按 aggregate_id 做稳定分区并为每个分区维护单一租约。
11.5 Centrifugo
单节点验证可以使用 memory engine,但生产多副本需要共享 Engine。Centrifugo 官方说明,Redis engine 会在节点之间传播发布,并保存频道 history/presence;客户端连接任意节点都能接收目标频道消息。参见 Engines and scalability。
示意配置如下:
{
  "engine": {
    "type": "redis",
    "redis": {
      "address": "redis+sentinel://redis-sentinel-a:26379?sentinel_master_name=realtime&addr=redis-sentinel-b:26379"
    }
  }
}
Relay 通过任意健康 Centrifugo 节点的 Server API 发布。共享 Redis Engine 会把消息转发到真正持有目标订阅的节点,因此 Relay 不需要知道某个浏览器连接在哪个 Pod。
11.6 Redis
两个 Centrifugo Pod 配一个单机 Redis,仍然只有一个新的单点。可选方式包括:
- 托管高可用 Redis;
- Redis Sentinel 主从切换;
- Redis Cluster;
- 规模更大时按频道进行应用级分片。
Sentinel 切换存在检测与选主窗口,因此高可用不等于零中断。连接侧必须允许重连,业务侧必须允许回快照。
11.7 负载均衡与连接排空
负载均衡器需要支持 WebSocket 升级和足够长的空闲超时。滚动发布时:
Pod 进入 terminating
  → readiness 变为 false
  → 不再接收新连接
  → 给存量连接一个排空窗口
  → 客户端重连到其他健康节点
  → SDK recovery 或业务快照补齐
不要求客户端永远粘在同一个节点;共享 Redis Engine 让新节点仍能访问同一频道分发与短期历史。粘性会话可以减少迁移,但不能成为正确性的前提。
十二、故障矩阵:每一层坏掉时会发生什么
| 故障 | 用户看到什么 | 系统如何恢复 | 不应发生什么 |
|---|---|---|---|
| 一个 Status API Pod 崩溃 | 某次请求失败或重试 | LB 切到其他 Pod,同 eventId 重试 | 重试生成两次状态变化 |
| MySQL 主库短暂切换 | 上报延迟、查询短暂失败 | writer endpoint 恢复后重试,事务原子性保持 | 返回成功但状态未落库 |
| Outbox Relay 暂停 | 数据库状态正确,页面更新延迟 | Relay 恢复后领取并清理积压 | 为追求实时绕过事实库 |
| 一个 Centrifugo Pod 崩溃 | 连接断开并重连 | 连接其他 Pod,先 recovery,失败则快照 | 把任务标成失败 |
| Redis 主节点切换 | 部分发布/恢复短暂失败 | Centrifugo 重连 Redis,客户端快照兜底 | 依赖 history 作为唯一事实 |
| 浏览器休眠 | 耗时暂时不刷新 | 恢复可见时重新校准 | 用错误本地时钟写回后端 |
| 消息重复 | 无可见变化 | version 忽略同版或旧版 | 重复新增任务行 |
| 消息乱序 | 无可见回退 | 仅应用更高版本 | 终态退回 RUNNING |
| 步骤业务失败 | 列表收到警告或失败摘要,详情显示具体功能与错误 | Coordinator 按 failurePolicy 重试、继续或提交 TASK_FAILED | 只在详情频道发送,导致列表用户完全不知情 |
| Worker 心跳超时 | 显示“状态待确认” | Health Reconciler 提交 health=STALE,恢复心跳后再提交 HEALTHY | 未确认事实时直接把任务写成 FAILED |
| Worker 完成后上报前崩溃 | 长时间 RUNNING / STALE | 来源 Outbox、持久重试或对账修复 | 认为中心 Outbox 能覆盖此缺口 |
高可用的目标不是让所有故障不可见,而是让故障有界、可观察、可恢复,并且不会破坏已确认事实。
十三、降级策略:实时层不可用时仍然可用
13.1 客户端连接状态
UI 应区分:
LIVE        实时连接正常
RECOVERING  正在重连和恢复
STALE       暂时无法确认最新状态
不要在连接断开时清空任务列表。保留最后一次已确认状态,显示“正在恢复实时更新”,并在恢复失败时触发批量快照。
13.2 低频批量校验
如果部署阶段尚未启用可靠 history,或希望防止某些静默丢失,可对当前可见且未终止的任务做低频批量校验,例如页面活跃时每 30~60 秒一次:
POST /api/tasks/status:batchGet

{"taskIds":["8a4d","9b5e"],"knownVersions":{"8a4d":"12","9b5e":"3"}}
轮询是兜底,不是每秒驱动 UI 的主链路。间隔应通过业务容忍度和容量测试确定,并加入随机抖动,避免所有客户端整点同时请求。
13.3 过载时优先保终态
中间 RUNNING 状态可以短窗口合并,但以下消息不能被普通合并规则吞掉:
SUCCEEDED、FAILED、CANCELLED;- 新任务创建;
- 新 attempt 开始;
- 权限撤销或任务删除;
- 需要用户操作的错误。
慢客户端积压时,可以丢弃可覆盖的旧摘要,只保留同一任务最高版本的完整状态;超过上限后主动断开,让客户端走恢复流程,不能无限增加内存队列。
十四、可观测性:监控正确性,而不只监控在线数
14.1 服务端指标
| 层 | 必须监控的指标 |
|---|---|
| 状态 API | 上报 QPS、P50/P95/P99、幂等命中、冲突、旧 attempt、功能身份不匹配、Schema 拒绝、心跳接收/拒绝、非法转换 |
| MySQL | 事务延迟、InnoDB 行锁等待、连接池等待、复制延迟、切换事件 |
| Outbox Relay | 最老未发布年龄、PENDING/PROCESSING/DEAD 数量、领取与发布速率、租约超时、失败分类 |
| Centrifugo | 在线连接、订阅数、发布速率、节点间 Broker 错误、断开原因 |
| Redis | CPU、内存、连接、Pub/Sub、复制延迟、故障切换 |
| 客户端 | 连接成功率、重连次数、recovered=false 比例、快照耗时、未知功能/Schema、异常通知展示延迟 |
比“当前在线 10 万连接”更有价值的两个端到端指标是:
state_commit_to_publish_seconds
状态提交到实时发布的延迟

state_commit_to_visible_seconds
状态提交到客户端可见的延迟
14.2 日志关联
一次状态变化至少应能用下面的字段串起来:
traceId
eventId
taskId
stepId
taskType
operationCode
dataSchema
attempt
executionId
sourceSeq
taskVersion
errorCode
outboxId
channel
日志中不要记录完整 JWT、签名密钥、Server API Key 或敏感任务结果。
14.3 告警优先级
建议先对“用户会长期看到错误状态”的问题告警:
- Outbox 最老记录年龄持续增长;
- 状态提交成功但发布延迟超出 SLO;
recovered=false比例突增;- 未终止任务超过最大合理运行时长;
- 同一任务行锁等待和版本冲突异常升高;
TASK_FAILED已提交但用户摘要投影未发布;- 某个
operationCode的 Schema 拒绝或错误码突然激增; - 心跳年龄分布、
STALE转换或旧 execution 心跳拒绝率突然升高; - Redis 或 MySQL 故障切换失败。
连接数下降可能只是业务低谷,Outbox 延迟上升却很可能意味着用户正在看到旧状态。
十五、容量模型:连接、变化和写入分开计算
假设:
在线连接                 100,000
活跃任务                  20,000
每个任务平均 30 秒一次状态变化
每次变化平均投递给 2 个客户端
平均消息体                    800 B
粗略估算:
状态写入:20,000 / 30 ≈ 667 次/秒
客户端投递:667 × 2 ≈ 1,334 次/秒
纯消息体流量:1,334 × 800 B ≈ 1.07 MB/秒
任务执行心跳必须单独计算。假设 20,000 个运行中步骤每 15 秒心跳一次:
心跳项:20,000 / 15 ≈ 1,333 项/秒
若每请求批量 100 项:约 14 个 HTTP 请求/秒
但若每项都立即落库:仍然约 1,333 次行更新/秒
批量只能降低 HTTP/TLS 开销,不能自动消除数据库写入。可以把 Worker 发送周期和 MySQL 持久化周期分开,例如 15 秒接收一次、同一 execution 最多每 30 秒持久化一次;但内存缓冲丢失后会缩短实际超时余量,因此必须把持久化周期计入 heartbeatTimeoutSeconds,并在状态服务重启或故障切换后启用宽限期。
这还没有计入 Centrifugo 连接心跳、协议头、重连和快照流量。连接数、业务状态变化量、任务执行心跳量、数据库写入量和热门频道扇出是不同维度,不能用“支持百万 WebSocket”替代系统容量测试。
至少要压测以下场景:
- 大量空闲连接;
- 稳态状态上报;
- 批量任务心跳、心跳延迟和状态服务恢复后的续租风暴;
- 单个热门项目的大扇出;
- Outbox 积压后追赶;
- 一个 Centrifugo 节点滚动下线;
- Redis 主从切换;
- MySQL 主备切换;
- 10%~30% 客户端同时重连;
- history 不足后集中读取快照。
15.1 数据量大时,先分清“堆积”的是哪一种数据
不能看到表变大就直接把所有表按同一种方式分库。当前态、心跳、不可变事件和待发布消息的生命周期完全不同:
| 数据 | 典型规模与写入特点 | 首选治理方式 | 不应该做的事 |
|---|---|---|---|
task / task_step 当前态 | 每个任务和步骤一行,会原地更新 | 只保留活跃与近期终态,旧任务归档 | 为了查历史让主库永久保存全部完成任务 |
| execution 心跳租约 | 高频更新,只有最新值有意义 | 独立窄表、批量写、按持久化周期合并 | 每次心跳都生成事件和通知 |
task_event_log | 只追加,通常是最大表 | 按时间分区、按保留期归档到对象存储或分析库 | 在线事务库永久保存无限审计明细 |
task_event_dedup | 与事件数接近,但只服务重试判定 | 保留时间覆盖最大重试/补交窗口,过期后批量清理 | 先删幂等记录却仍无限期接受旧事件 |
task_outbox | 短期热数据,会有积压尖峰 | 发布后短期保留,分批清理;积压先扩 Relay | 把 PUBLISHED 记录永久留在领取索引中 |
| 状态/功能定义 | 小而读多 | 版本化后复制或缓存到各分片 | 每次事件都跨库查询中心配置 |
因此扩展顺序通常是:先控制保留期与载荷,再做冷热分离,再做单库分区,最后才做水平分库。如果增长来自无限保存 5 KB 的事件 payload,分成十个库只是把清理问题复制了十份。
心跳尤其适合从 task_step 垂直拆到 task_execution_lease 窄表,只保留 execution_id、heartbeat_seq、last_heartbeat_at、health、stale_since。这样高频续租不会反复改写带 JSON、错误详情和业务状态的大行,也能单独设置索引和批量更新策略;权威业务状态仍在 task_step,Reconciler 只在健康状态真正变化时才产生版本事件。
15.2 MySQL 分区和分库不是一回事
MySQL 表分区仍在同一个数据库实例内,适合管理超大的时间序列表、裁剪扫描范围和快速淘汰整段历史,但它不会增加写主库的 CPU、IO 或连接上限,也无法消除同一个热门任务的行锁竞争。
例如事件日志可在每个物理分片内按 committed_at 做月分区,但实施前必须调整主键和唯一键:MySQL 要求分区表达式使用的列出现在每一个唯一键中。当前示例的 PRIMARY KEY(event_id) 不能直接改成按 committed_at 分区;要么使用包含时间列的复合唯一键并把幂等唯一性留给 task_event_dedup,要么使用按月物理表并由查询层合并。不要在生产库上直接执行一条未经验证的 ALTER TABLE ... PARTITION BY。具体限制参见 MySQL 官方的 Partitioning Keys, Primary Keys, and Unique Keys。
真正的水平分库是让不同任务进入不同 MySQL writer,每个库只承担一部分事务。因为 taskVersion 只要求在单个任务内递增,系统不需要跨分片的全局自增序列,这正是按任务聚合根拆分的优势。
15.3 推荐路由:虚拟桶固定任务归属,同一任务永不跨库事务
先把三个概念拆开:
任务 task-8a4d
  → 固定属于虚拟桶 bucket-10
  → bucket-10 当前映射到 mysql-shard-b
- 任务是业务对象,一旦创建就不改变
taskId; - 虚拟桶是一个稳定的逻辑号码,不是数据库、表或进程;
- 物理分片才是真正承载数据的 MySQL 集群,可以随着扩容而变化。
虚拟桶的价值就是在“业务 ID”和“物理数据库”之间加一层可移动的间接映射。任务固定在桶里,扩容时改变“桶去哪个库”,而不是改变“任务怎么算哈希”。
15.3.1 为什么不能直接使用 hash(taskId) % 数据库数量
假设最初只有两个数据库:
shard = hash(taskId) % 2
增加第三个数据库后变成:
shard = hash(taskId) % 3
模数从 2 变成 3,大量任务会突然算到另一个库。为了让新公式成立,几乎要全量搬迁旧数据;迁移期间同一个 taskId 还可能被旧实例路由到 A、新实例路由到 C,产生两个权威副本。
虚拟桶把会变化的数据库数量从哈希公式中拿掉:
bucketId = stableHash(routingKey) % 4096  // 永远使用 4096
shardId  = bucketMap[bucketId]           // 查当前映射
以后从 2 个库扩到 3 个、5 个或 20 个库,bucketId 都不重新计算,只调整少量 bucketMap 记录。
15.3.2 用 16 个桶完整演示一次
生产可以使用 4096 个桶。为了看清逻辑,这里只用 16 个:
固定桶数量:16,编号 0~15

初始映射:
bucket 0~7   → mysql-shard-a
bucket 8~15  → mysql-shard-b
创建任务时,状态服务已经从登录身份得到 tenantId=t-01、ownerId=u-88。如果系统以 owner 作为路由主体:
routingKey = "v1\u001ft-01\u001fu-88"
illustrativeHash(routingKey) = 42762 // 仅为解释取模,不是指定算法的真实输出
bucketId = 42762 % 16 = 10
bucketMap[10] = mysql-shard-b
于是这个用户创建的任务写到 mysql-shard-b。状态服务生成的 taskId 可以携带桶提示,例如:
tsk_0A_01K8M7...
    └─ bucket 10 的 Base32 编码,只是路由提示,不是权限凭证
后续 AI 服务只需透传 taskId 或 executionHandle。Status Gateway 解析出 bucketId=10,读取本机内存中的 bucketMap[10],就能直达 mysql-shard-b,不需要广播查询所有数据库。
现在增加 mysql-shard-c,只把四个桶迁过去:
| 虚拟桶 | 扩容前 | 扩容后 |
|---|---|---|
0、1、2、4、5、6 | shard-a | shard-a,不动 |
3、7 | shard-a | shard-c,迁移 |
8、9、10、12、13、14 | shard-b | shard-b,不动 |
11、15 | shard-b | shard-c,迁移 |
bucket-10 没有被选中,所以 task-8a4d 仍在 shard-b;只有落在 3、7、11、15 的任务需要搬迁。虚拟桶把扩容单位从“全库所有任务”缩小成“选中的几个桶”。
15.3.3 哈希规则必须像 API 协议一样固定
所有语言和版本必须对相同路由键得到相同桶号,不能直接调用某个语言的默认 hashCode():默认算法可能跨进程随机化,也可能在升级后变化。应明确冻结:
hashVersion = v1
characterEncoding = UTF-8
separator = 0x1F
algorithm = xxHash64 或 MurmurHash3-128 的固定实现
unsignedConversion = 明确的大端/小端规则
bucketCount = 4096
并维护跨语言测试向量:
| 输入 | 期望 64 位哈希 | 期望桶号 |
|---|---|---|
v1␟t-01␟u-88 | 固定测试值 | 10 |
v1␟t-01␟u-99 | 固定测试值 | 2037 |
表里的数字应由最终选定算法真实生成,上面的值只展示测试形式。哈希算法、字符编码、字段顺序或分隔符任何一个改变,都必须发布 hashVersion=v2,不能静默修改线上计算结果。
15.3.4 bucketMap 到底保存在哪里
映射是很小、低频变化的控制面数据。4096 个桶即使每条记录几百字节,也只有几 MB。可以在高可用配置库中保存权威版本,再把完整快照下发到每个 Status API 实例的内存:
CREATE TABLE shard_bucket_route (
  bucket_id SMALLINT UNSIGNED NOT NULL COMMENT '稳定虚拟桶编号,例如 0 到 4095',
  route_epoch BIGINT UNSIGNED NOT NULL COMMENT '该桶每次切换物理分片时递增的路由纪元',
  physical_shard VARCHAR(64) NOT NULL COMMENT '当前唯一允许写入的物理 MySQL 分片标识',
  route_state VARCHAR(16) NOT NULL COMMENT 'ACTIVE、COPYING、CUTOVER 或 DRAINING',
  source_shard VARCHAR(64) NULL COMMENT '迁移期间的数据来源分片',
  target_shard VARCHAR(64) NULL COMMENT '迁移期间准备接管写入的目标分片',
  fence_token CHAR(36) NOT NULL COMMENT '切换写入所有权时使用的 fencing token',
  updated_at DATETIME(3) NOT NULL COMMENT '映射最后更新时间',
  PRIMARY KEY (bucket_id)
) ENGINE=InnoDB COMMENT='虚拟桶到物理 MySQL 分片的版本化路由映射';
数据面不能每次上报都查询这张表,否则路由库会成为新瓶颈和单点。推荐流程是:
- 控制面发布带全局配置版本的完整
bucketMap; - Status API 启动时加载一次,之后通过 watch、配置推送或轮询获得新快照;
- 新快照校验完整性后原子替换内存指针,不能逐条更新导致半新半旧;
- 每条桶记录带自己的
routeEpoch,迁移期间可以精确识别哪个桶已过期; - 控制面短暂不可用时,已有实例继续使用最后一份有效快照;没有可信快照的新实例保持未就绪,不能猜测分片。
应用配置中的 physical_shard 只是逻辑名,例如 status-shard-b,再由密钥管理和连接配置解析 writer endpoint。映射表不能保存数据库密码。
15.3.5 taskId 如何找到桶:编码提示或路由目录
有两种实现,二选一即可:
| 方式 | 请求如何找到桶 | 优点 | 代价 |
|---|---|---|---|
| ID 携带桶提示 | taskId 的固定字节保存 bucketId | 不需要目录查询,吞吐稳定 | ID 格式必须长期兼容;桶号不等于授权 |
| 路由目录 | 查询 taskId → bucketId,本地与 Redis 只做缓存 | 可以保持现有随机 ID 不变 | 目录本身要高可用、分层缓存并规划容量 |
不论哪种方式,taskId 都只指出虚拟桶,不能写死物理库名。否则 bucket-11 从 shard-b 搬到 shard-c 后,旧 ID 会永远指向错误数据库。
executionHandle 也应绑定 workflowId、taskId、bucketId、routeEpoch、executionId、producerId、expiresAt。其中 bucketId 用于快速路由,routeEpoch 用于发现调用方或网关缓存过期;服务端仍要校验签名、task→workflow 关系、当前 execution 和数据库中的权威步骤,不能因为句柄带桶号就跳过鉴权。
15.3.6 一次创建和一次上报到底怎样路由
这里没有“先查 shard-a,找不到再试 shard-b”。一次请求只能由当前映射选出一个权威 writer。连接失败时返回可重试错误;刷新映射后仍只重试到新映射指定的分片,并保持同一个 eventId。
建议先定义固定数量的虚拟桶,例如 4096 个:
virtualBucket = hash(tenantId + ":" + routingSubject) % 4096
physicalShard = bucketMap[routeEpoch][virtualBucket]
routingSubject 的选择取决于最重要的查询:
| 路由键 | 优点 | 风险 | 适用场景 |
|---|---|---|---|
tenantId + ownerId | 同一用户的任务列表、当前态与事件都在一个分片 | 超级账号或机器人用户可能成为热点 | 大多数面向终端用户的任务中心,推荐默认值 |
tenantId + taskId | 写入最均匀,单个大租户也容易摊开 | 用户任务列表需要跨分片或单独读模型 | 平台型、机器账号、高吞吐任务 |
只按 tenantId | 租户隔离和迁移直观 | 大租户会独占热点,负载极不均衡 | 租户规模可控或独占集群 |
| 按时间 | 删除方便 | 同一任务可能跨分片,最新时间分片持续热点 | 不适合作为在线任务状态的主路由键 |
无论选哪种路由,task、task_step、task_execution_lease、task_event_log、task_event_dedup、task_outbox 必须跟随同一个任务落在同一物理分片,让“校验、改当前态、分配版本、写事件、写 Outbox”仍是一个本地 InnoDB 事务。分库后不要再依赖跨库外键;由状态服务校验聚合内引用,并使用 UUID/ULID 保证全局 ID 不碰撞。
workflow 是另一个聚合根,不要求为了顶层分组把其下所有 task 强塞进同一个分片。采用 tenantId + ownerId 路由时它们通常自然同库;采用 tenantId + taskId 路由时,workflow 元数据可以位于控制分片,workflowId → taskId 成员关系由幂等索引和 Outbox 投影维护。task 状态提交永远只依赖本 task 的本地事务,workflow 聚合允许稍后收敛,避免引入跨分片锁和两阶段提交。
第一版推荐 tenantId + ownerId,因为最常见入口是“当前用户的任务列表”。若压测证明存在超级账号热点,再把该 owner 分配到多个稳定 owner bucket,并为用户列表建立读模型,而不是一开始就让所有普通查询跨库散射。
15.3.7 分库后还要不要分表
虚拟桶主要解决“去哪个数据库”。每个物理分片可以继续使用同名表,这是最简单的方案。只有单表索引、DDL、归档或备份窗口仍然过大时,再增加稳定表槽:
physicalShard = bucketMap[bucketId]
tableSlot = bucketId % 16
taskTable = task_00 ... task_15
桶迁移到另一个数据库后 tableSlot 不变,因此复制关系清晰。不要使用 hash(taskId) % 当前表数量 后再随意增加表数量,否则会重演直接按数据库数量取模的全量重映射问题。分表仍在同一个 MySQL 实例时主要降低单表维护成本,不能提升该实例的 CPU、IO 或连接上限。
15.4 workflowId 顶层申请一次,每个独立 taskId 也只申请一次
创建业务流程时先生成一次 workflowId,后续所有子任务都携带它用于归组。每创建一个独立任务,状态服务再为该 task 选择虚拟桶并生成唯一 taskId。可以让 taskId 带一个不泄露租户信息的桶提示,也可以在路由目录中保存 taskId → virtualBucket + routeEpoch;激活步骤后,短 executionHandle 同样绑定这份路由。
业务命令建议同时携带 workflowId + taskId 方便追踪,但数据面路由只信任签名句柄或数据库中 task 对应的权威 workflowId。下游不需要携带 MySQL 主机名、库名和分表名,也不能通过篡改 workflowId 把 task 移到另一个流程。
请求到达任意 Status API 实例后:
taskId / executionHandle(workflowId 只作校验和归组)
  → 校验签名或查路由缓存
  → 得到 virtualBucket + routeEpoch
  → bucketMap 定位物理分片
  → 在该分片执行完整本地事务
  → 返回 taskVersion / stepVersion
路由缓存未命中时回源路由目录;目录不可用时,已缓存路由仍可服务,但不能凭猜测写到另一个分片。客户端若带了旧 routeEpoch,网关重新解析后转向新分片,避免迁移期间双写两个权威状态。
如果当前 bucketMap 已经是 routeEpoch=43,而请求句柄仍携带 42,网关不应该直接相信旧物理地址。它使用稳定的 bucketId 查当前映射:尚未切换时继续发往旧库;已经切换时转到新库,并依靠相同 eventId 做幂等重试。外部客户端不需要理解 routeEpoch,它只是服务端识别陈旧路由的内部机制。
15.5 用户跨任务查询和广播不要扫描所有分片
如果采用 tenantId + taskId 分布写入,GET /me/tasks 和 GET /workflows/{workflowId}/tasks 都不能在每次刷新时同步查询所有分片。应由各分片 Outbox 异步维护按 tenantId + ownerId + updatedAt 排序的 user_task_index,以及按 workflowId + taskId 排序的 workflow_task_index 读模型;创建任务的响应可以直接把新任务放入客户端缓存,读模型随后收敛。单任务详情仍按 taskId 直达权威分片。
实时通知也不需要扫库。每个分片的 Relay 只发布本分片 Outbox,频道仍是 user:{tenant}:{user} 和 task:{tenant}:{taskId};同一个用户即使任务分布在多个库,也会在同一个用户摘要频道收到更新。Centrifugo 合并的是频道消息,不要求所有任务来自同一个 MySQL。
广播则走独立控制面:
- 全站维护通知直接发布受控广播频道,不为每个用户插入一条任务事件;
- 租户或人群广播先生成一个
broadcastId,再由分片 fan-out 作业按批次投递轻量引用; - 客户端收到引用后按权限拉取正文,避免一条大消息乘以百万连接;
- 需要“每个用户都已读/未读”的场景才创建用户级投递记录,并把它当独立通知系统容量规划。
15.6 归档、扩容和故障恢复的边界
建议为已完成数据定义明确生命周期,例如:在线当前态保留 30~90 天、在线事件保留 7~30 天、幂等记录覆盖“最大可接受事件年龄 + 重试宽限期”、已发布 Outbox 保留 1~7 天。具体天数由合规、排障和产品查询窗口决定,不能照抄示例。归档任务使用分页水位和幂等清单,把事件与大 payload 写入对象存储或历史库并校验条数/校验和后,再按分区或批次从在线库清理。
扩容时移动虚拟桶,而不是重新计算所有任务的哈希。迁移工具必须同时处理当前态、心跳租约、未归档事件、幂等记录与未发布 Outbox;只搬 task 表会导致重复事件、漏通知或旧 execution 在错误分片续租。
15.6.1 一个桶如何从 shard-b 安全移动到 shard-c
bucketMap 只解决“新请求应该去哪”,还必须防止持有旧缓存的 API 实例继续写旧库。每个物理分片应有本地写栅栏:
CREATE TABLE bucket_write_fence (
  bucket_id SMALLINT UNSIGNED NOT NULL COMMENT '本分片承载的虚拟桶编号',
  route_epoch BIGINT UNSIGNED NOT NULL COMMENT '本分片允许写入的路由纪元',
  fence_token CHAR(36) NOT NULL COMMENT '迁移协调器签发的写所有权令牌',
  writable BOOLEAN NOT NULL COMMENT '当前分片是否仍是该桶唯一 writer',
  updated_at DATETIME(3) NOT NULL COMMENT '写栅栏最后更新时间',
  PRIMARY KEY (bucket_id)
) ENGINE=InnoDB COMMENT='物理分片本地的虚拟桶写入所有权栅栏';
每个状态写事务先执行一次 SELECT ... FOR SHARE,校验 bucketId + routeEpoch + fenceToken + writable=true,并把共享锁持有到事务提交。同一个桶的普通事务可以并发持有共享锁;迁移协调器更新栅栏需要排他锁,因此会等待已经开始的事务结束,并阻止之后的旧路由写入。
完整迁移顺序如下:
关键点有五个:
COPYING阶段旧分片仍是唯一 writer,目标分片只是不可对外写的副本;- 切换时先关闭旧分片写栅栏,让旧路由即使存在也写不进去;
- 最后增量追平并校验后,才启用目标栅栏和增加
routeEpoch; - Worker、REST 或 gRPC 重试必须保持原
eventId,路由刷新不能制造第二个事件; - 旧分片先进入
DRAINING并保留只读观察窗口,确认无回滚需要后再清理,不能切换后立即删除。
不推荐在两个 MySQL 分片之间做应用双写:网络超时会让系统无法判断哪边成功,反而重新制造分布式事务。迁移期应始终只有一个可写分片,依靠复制、短暂写冻结、数据库栅栏和幂等重试完成切换。如果目标副本校验失败,就保持旧分片为 writer 并终止切换。
每个物理分片都要独立配置 Multi-AZ、备份、PITR、容量告警和 Relay。分片只能降低单库压力,不会自动提供高可用;反过来,分片越多,恢复演练和路由正确性的运维成本越高。
15.7 什么时候真的需要分库分表
先为单库建立触发线,再决定升级。持续出现下面任意一类证据才进入分片设计评审:
- 峰值写入下主库 CPU、IO 或 redo/binlog 吞吐长期逼近安全水位;
- 事件/Outbox 索引已无法稳定驻留,领取与按任务查询延迟持续恶化;
- 大表维护、备份恢复或 DDL 时间超过可接受窗口;
- 清理和归档已经正确实施,容量仍按业务增长不可接受;
- 单个租户或账号热点已通过限流、批量和心跳合并仍无法控制;
- 故障恢复时间随数据规模增长,已经超过业务 RTO。
分片验收不能只测正常写入,还要测路由缓存失效、单分片切主、单桶迁移、旧 routeEpoch 请求、Relay 跨分片积压、用户任务跨分片聚合以及归档恢复。这样才能证明“扛住”不仅是写得快,也包括故障后找得到、补得齐、不会串任务。
十六、分阶段落地,不要第一天就堆满组件
阶段 1:单机验证
现有业务后端
  + MySQL 8.0
  + 单实例 Outbox Relay
  + 单实例 Centrifugo memory engine
先验证:
- 状态机与幂等;
- 最小任务可以在
productId/taskType=null时创建并使用通用生命周期; - 动态步骤注册幂等、受权限与配额控制,普通事件不能自动创建步骤;
authorityScope + operationCode + eventType的功能路由与权限校验;- 各功能
data.schema校验、差异化投影和未知 Schema 降级; - 多服务各自维护
sourceSeq,状态服务统一分配taskVersion; - 并发事件的任务版本唯一、递增,重复事件返回第一次分配的版本;
- Outbox 原子性;
- 用户摘要和任务详情频道;
- 失败、自动重试、
STALE与终态异常通知; - 订阅权限;
- 快照与实时消息合并;
- 前端本地计时。
阶段 2:生产高可用
Status API 多副本
  + MySQL Multi-AZ
  + Outbox Relay 多副本
  + Centrifugo 多副本
  + Redis HA Engine
  + LB / Ingress
加入滚动发布、连接排空、短期 history、恢复失败回快照、端到端告警和故障演练。
阶段 3:规模化
当证据表明 MySQL Outbox 扫描、Relay 发布或 Redis 成为瓶颈,再考虑:
- 按保留期治理 Outbox,并按虚拟桶或物理分片并行领取;
- 将消费链路升级到 Kafka、NATS JetStream、Redis Streams 或云消息服务;
- 用固定虚拟桶分片,依据核心查询在
ownerId与taskId路由之间选择; - 管理看板只订阅聚合指标,不接收所有任务明细;
- 将审计历史与当前状态查询分离。
升级依据应该是积压、CPU、锁等待、恢复风暴和成本数据,而不是“系统看起来应该用 Kafka”。
十七、生产验收清单
正确性
- 相同
eventId重试不会产生第二次状态变化; - 相同
eventId携带不同内容会被拒绝; - 相同
clientWorkflowKey重试只返回同一个workflowId,相同workflowId + clientTaskKey重试只返回同一个taskId; - task 创建后不能通过修改请求中的
workflowId被移动到另一个 workflow; - Task Envelope、Step Registry、命令中的 Execution Context、签名 Token 与当前
task_step必须完全匹配,不能只凭taskId接受事件; -
productId/taskType为空时仍可创建、查询、通知和完成通用任务; - 相同
clientStepKey + attempt重试只返回同一个动态 execution; - 未注册的普通状态事件不能隐式创建
stepId或 execution; - 动态步骤受到允许的 operation 命名空间、最大数量、深度、并发和注册速率限制;
- 自由
phaseCode只能更新受限进度元数据,不能声明终态、严重级别或失败策略; - 同一服务并发执行多个任务时,每个
executionId都有独立 Reporter、sourceSeq和heartbeatSeq,异步回调不会串任务; - 服务重启后能从本地 Outbox 继续发送原
eventId,业务结果已提交但完成事件暂未送达时可由对账恢复; - 紧凑
executionHandle能唯一解析到当前 execution,过期、撤销、错误生产者和旧 attempt 的句柄都会被拒绝; - REST、REST 批量与 gRPC 对相同
eventId返回相同幂等结果和taskVersion,不会出现协议分支状态机; - gRPC 流重连后重新绑定 execution,临时
streamExecutionKey不会被持久化为业务身份; - Token、步骤定义与请求中的
taskType/operationCode/producerId不一致时会被拒绝; - 功能数据只接受注册过的
data.schema,未知 Schema 不会污染当前状态; - 同一功能的摘要、详情和广播投影遵守各自字段白名单;
- 旧 attempt、旧
sourceSeq、旧version都不能覆盖新状态; - 同一任务中,服务 A 的
sourceSeq=2不会让服务 B 的sourceSeq=1被误判为旧事件; - 两个服务并发上报时得到不同且连续递增的
taskVersion; - 重复
eventId返回第一次提交的taskVersion,不会再次增加版本; - 终态不会退回运行态;
- 未注册业务状态会被拒绝,业务状态只能映射到服务端定义的生命周期;
- 状态定义升级不会改变运行中和历史任务的语义;
- 当前状态、不可变事件、版本、幂等结果与 Outbox 在同一个事务里提交;
- 事件时间线可以从
afterTaskVersion断点续取,并能识别已被清理的历史窗口; - Worker 上报的单调时钟耗时不会被跨机器墙钟差值覆盖;
- 摘要和详情分别维护版本门;
-
workflowVersion与各任务的taskVersion独立比较,任一子任务的版本都不会覆盖兄弟任务或 workflow; - 同一用户摘要频道可以交错接收多个
taskId,客户端按taskId分桶并只比较各自的taskVersion; - 同一 workflow、批次和父子关系下的任务仍各自拥有独立
taskId、版本和终态,关联 ID 只建立关系; - 摘要消息不携带未订阅任务的完整步骤、敏感输入或完整结果;
- 初始化期间的新消息不会被旧快照覆盖。
- 客户端不认识某个
operationCode或data.schema时仍能展示通用生命周期状态。 - 用户未订阅任务详情时,仍能从用户摘要频道收到任务失败或需操作提醒。
-
STALE只改变健康状态,不会被误报成业务FAILED。 - 普通心跳不会递增任务版本或产生实时消息,只有健康状态变化才发布。
- 旧 attempt、错误
executionId和非递增heartbeatSeq不能续租当前步骤。 - 同一 execution 从
STALE恢复时只产生一次HEALTHY版本变化。 - 状态服务或 MySQL 切换期间有宽限期,不会把大量健康任务同时误判为
STALE。 -
STEP_FAILED、终态和需操作通知不会被进度消息合并策略吞掉。
安全
- 连接 JWT 来自已验证登录身份;
- 任务详情 Token 在服务端重新检查权限;
- 浏览器无法自行指定其他租户频道;
-
workflowId和taskId都不是权限凭证,服务端会按当前用户计算可见 workflow、task 和消息字段; -
authorityScope来自可信服务身份并且创建后不可修改,productId不参与鉴权或频道授权; - JWT 密钥、Server API Key 不出现在前端;
- 内部上报有服务身份认证、限流和审计。
- 任务详情订阅数在服务端强制限额,Token 短期有效;
- 原生 SSE watch set 逐项校验任务 ACL、数量限制、会话归属和过期时间;
-
task_acl撤销后会发布移除事件,并阻止该用户继续快照查询或详情订阅; - 项目、租户和系统广播不包含越权任务详情。
高可用
- Status API 任一副本退出后请求可重试;
- Centrifugo 任一节点退出后客户端能重连其他节点;
- Redis 与 MySQL 切换经过真实演练;
- Outbox 暂停后可以追赶且不会回退客户端状态;
- history 不足时客户端会读取快照;
- 重连风暴有退避、抖动和容量余量;
- 取消或恢复某个任务详情订阅,不会中断同一物理连接上的用户摘要和其他任务详情;
- 备份做过恢复验证。
- 当前态、心跳租约、事件、幂等和 Outbox 分别定义保留期、清理水位与容量告警;
- 每个任务的状态、事件、幂等和未发布 Outbox 始终位于同一权威分片;
- workflow 聚合跨分片时通过幂等投影最终收敛,task 提交路径不依赖跨库事务;
- 路由缓存失效、旧
routeEpoch、单桶迁移和单分片切主经过故障演练; - 跨分片用户列表使用有界读模型,不在在线请求中无上限散射查询。
可观测性
- 能从
workflowId查到有权查看的 task 成员,也能从eventId查到对应任务版本和 Outbox 记录; - 能看到 Outbox 最老积压年龄;
- 能区分发布失败、权限失败、恢复失败和快照失败;
- 有状态提交到客户端可见的端到端延迟指标;
- 对长期 RUNNING / STALE 任务有对账和修复流程。
十八、最终结论
任务状态同步系统最重要的设计原则不是选 SSE 还是 WebSocket,而是建立清晰的可靠性边界:
状态服务成功响应
  = 状态已经持久化

Outbox 发布
  = 尽力把已提交状态快速送到实时层

实时推送
  = 更快的用户体验,不是唯一事实

version + snapshot
  = 重复、乱序、断线和节点切换后的最终正确性
在这个边界之上,Centrifugo 解决连接、频道、重连与多节点分发,MySQL 负责权威状态和事务,Outbox Relay 负责可靠发布,Redis 负责实时集群协调,前端负责按版本合并和本地计时。任何一层短暂不可用,都不会要求重新定义业务状态。
最终可以把方案收敛为十八句话:
- 状态先落库,再通知;
- 同一事务写当前状态、不可变事件、版本、幂等结果和 Outbox;
- 顶层业务流程使用
workflowId,其下每个可独立运行和结束的工作单元使用自己的taskId; workflowVersion与各任务的taskVersion是独立版本域,兄弟任务不共享状态机、终态或写锁;- 每个服务只维护自己的
sourceSeq,状态服务统一分配任务级taskVersion; taskType/productId可以后绑定,安全边界始终来自不可变的authorityScope;operationCode区分具体功能,eventType区分发生的动作;动态步骤先注册 execution,再上报事件;- 公共信封保持稳定,功能差异通过版本化
data.schema + data.value表达; - 稳定生命周期保证正确性,注册业务状态负责产品语义,自由
phaseCode只描述可覆盖中间阶段; - 失败、失联和通知故障分别建模,不能统一伪装成
FAILED; - 中间服务按 execution 发送任务级心跳,普通心跳不推送,健康变化才产生新版本;
- 一个用户可关联多个 workflow 和 task,ID 只负责定位,真正隔离来自租户边界和 ACL;
- 用户摘要发现多个新任务和异常,workflow 摘要负责聚合,任务详情按需且有限订阅;
- 一条 WS 或 SSE 物理连接复用用户摘要、workflow 摘要与多个逻辑详情流;
- 连接 JWT 识别用户,订阅 JWT 或服务端 watch set 授权具体任务;
- 广播范围由服务端计算,范围越大,载荷越小;
- 消息可以重复和乱序,客户端只在对应 workflow 或 task 的版本域内接受更高版本;
- 短断线用 history 恢复,恢复失败读取权威快照;增长先用保留期、冷热分离和分区治理,确需分库时以虚拟桶固定 task 归属。
做到这些,系统才真正同时具备轻量、近实时、可扩展和可恢复,而不是只在演示环境里“看起来很实时”。